

 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。
AI 工具与开源生态动态
AI 工具、模型与开源生态的资料整理与解读,低成本建立持续判断力
17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。
 Qwen3.8-Flash-Next每秒70词元?本地加速之前,先看模型究竟改了什么
同样叫Flash-Next,70词元/秒背后可能是另一条计算路径:每词元激活专家从10减到5,再训练共享专家补偿。本文对照单台DGX Spark的两套原始资料,拆开量化、MTP、输入速度、输出速度和并发吞吐,不把128GB统一内存结果套到16GB显卡。
 GPT-6 Astra 发布:游戏开发、3D 建模与长程 Agent,距离 AGI 通用人工智能还有多远?
2026 年 9 月 3 日,OpenAI 发布 GPT-6 Astra,强化电脑操作、专业制作与长程任务能力。先看本次发布的核心升级,再结合游戏开发、Blender 房屋、Playco 与 ARC Prize 评估,理解它在 AGI 通用人工智能方向的进展和仍待验证的问题。
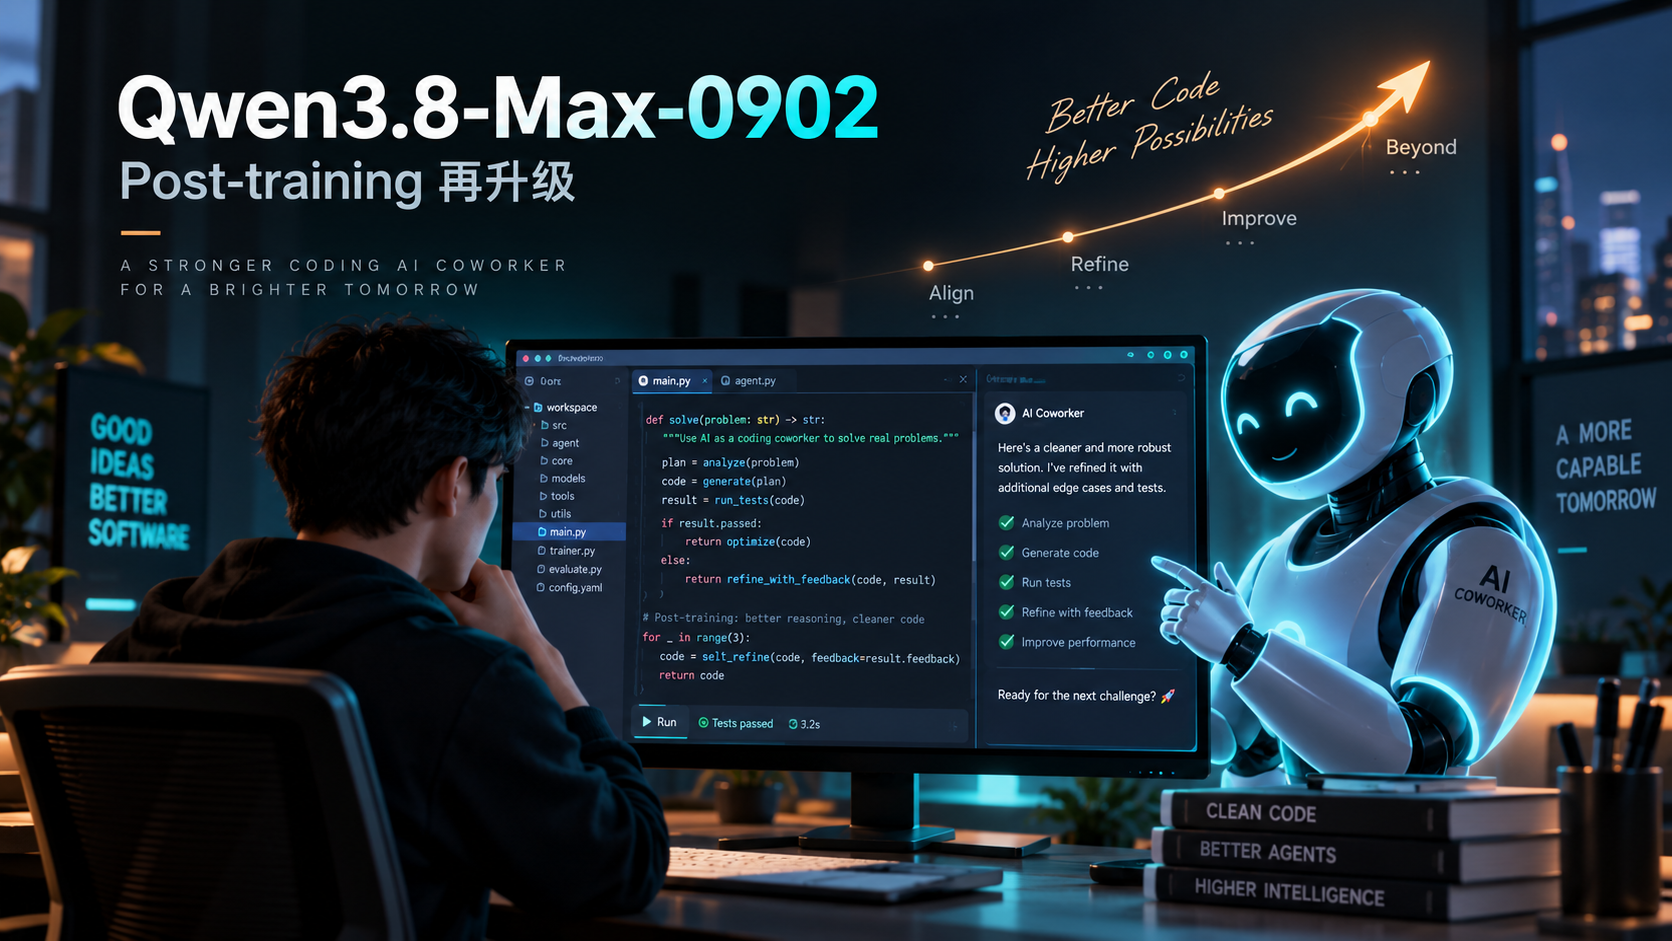 Qwen3.8-Max-0902:不是换架构,而是继续 Post-training,发布时 Code Arena 从 1669 升到 1691
Qwen3.8-Max-0902 是 Qwen3.8-Max 的日期快照升级,不是一次新架构发布。阿里云官方文档把重点放在工程级 Coding、长程自主开发、多工具协作与端到端交付;发布时 Code Arena WebDev 从 1669 升到 1691,但实时榜单随后已经变化。
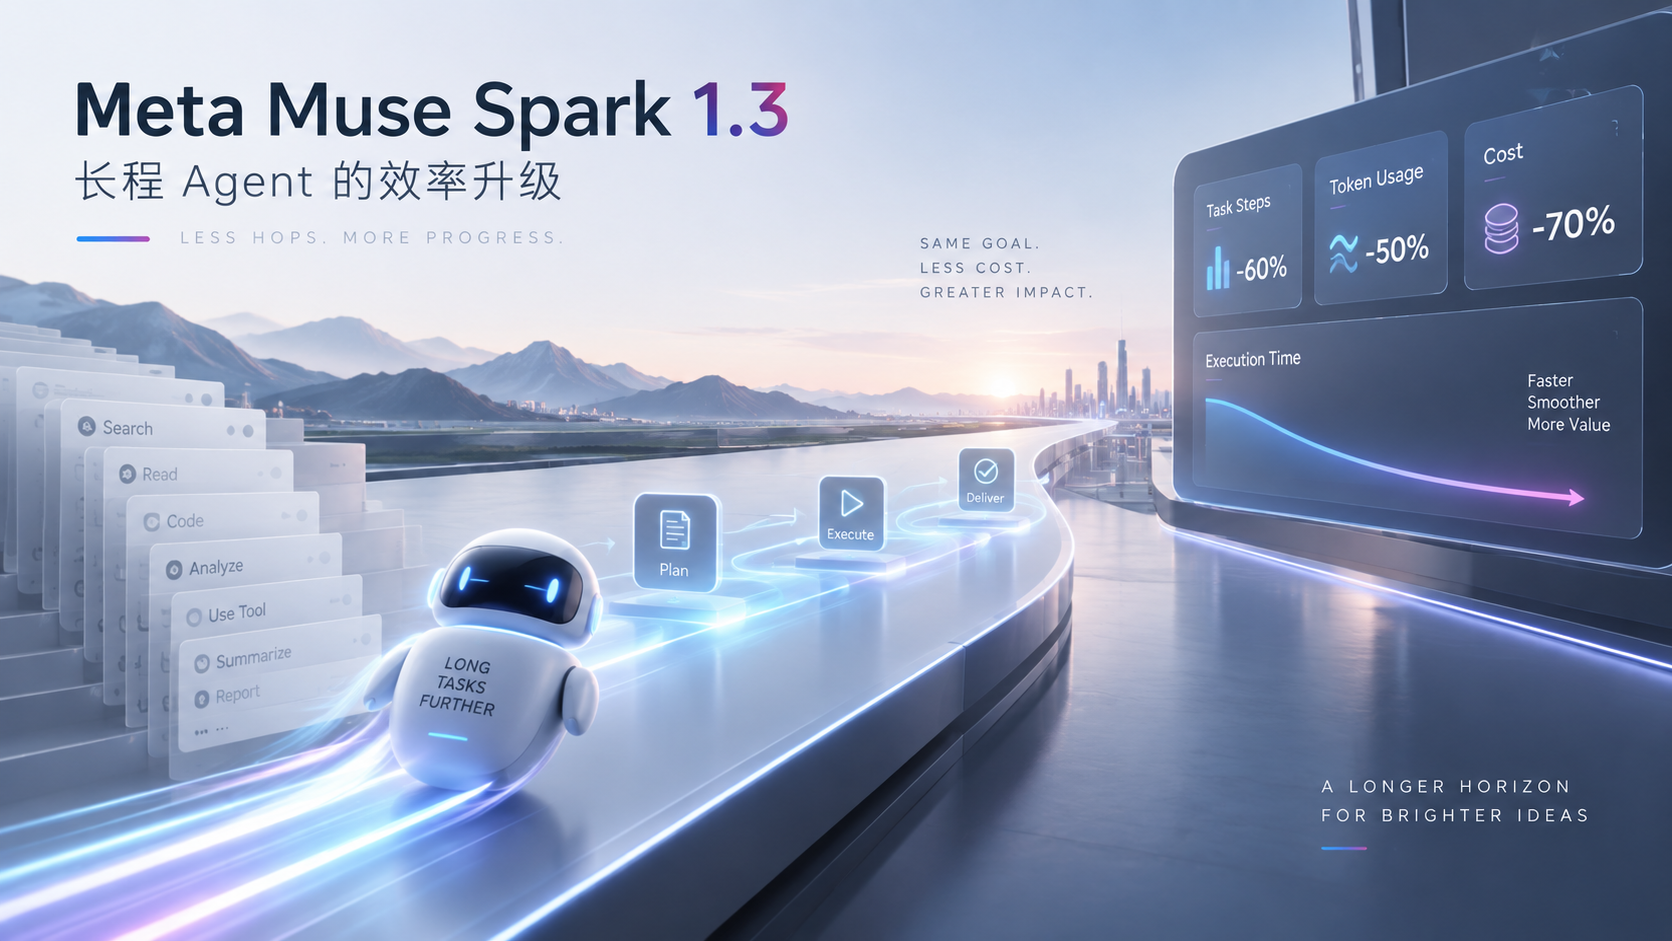 Meta Muse Spark 1.3:工具调用少 20%、Token 少 25%,长程 Agent 的“效率”开始不能只看 Token 单价
Meta 发布 Muse Spark 1.3,把长程 Agent 的重点从“会不会调用工具”推进到“是否知道何时澄清、何时求助、何时确认、何时少走无效轮次”。Meta 工程师内部对比称工具调用减少约 20%、Token 减少约 25%,但第三方评测提醒:这些节省不能直接外推到所有任务。
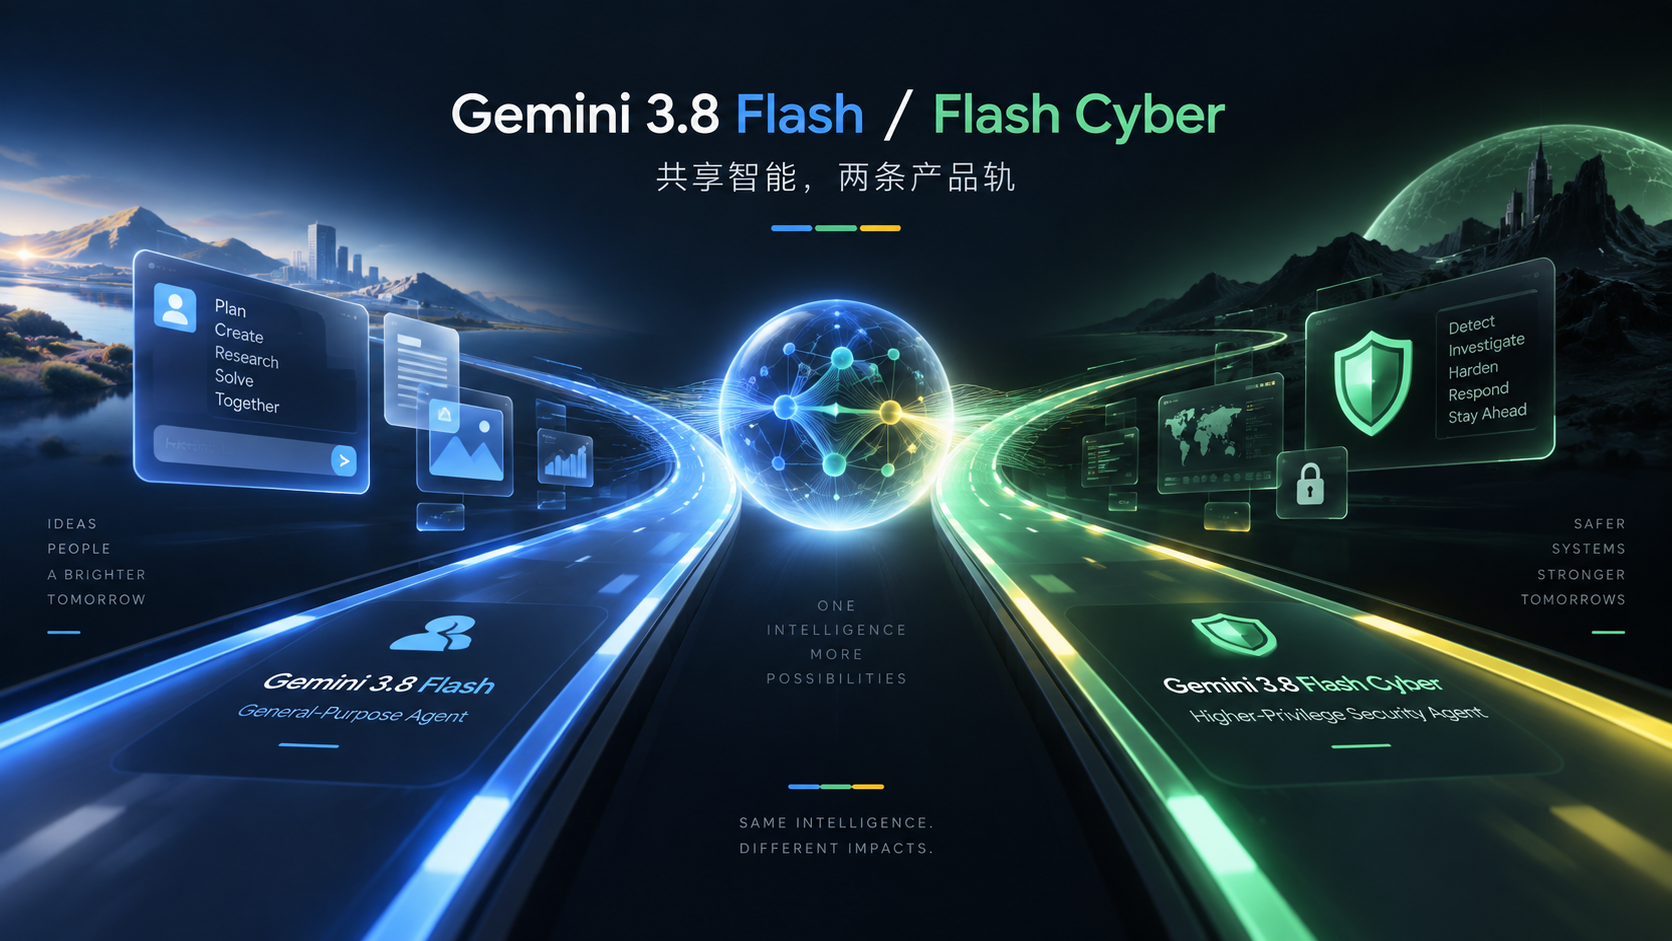 Gemini 3.8 Flash 与 Flash Cyber:Google 把通用 Agent 和高权限安全能力拆成两条发布轨道
Google 同时发布 Gemini 3.8 Flash 与 Flash Cyber:前者已经 GA,面向长程软件工程和自主 Agent;后者共享基础智能,却通过 Fairwind Program 只向可信防御方开放更宽松的网络安全能力。
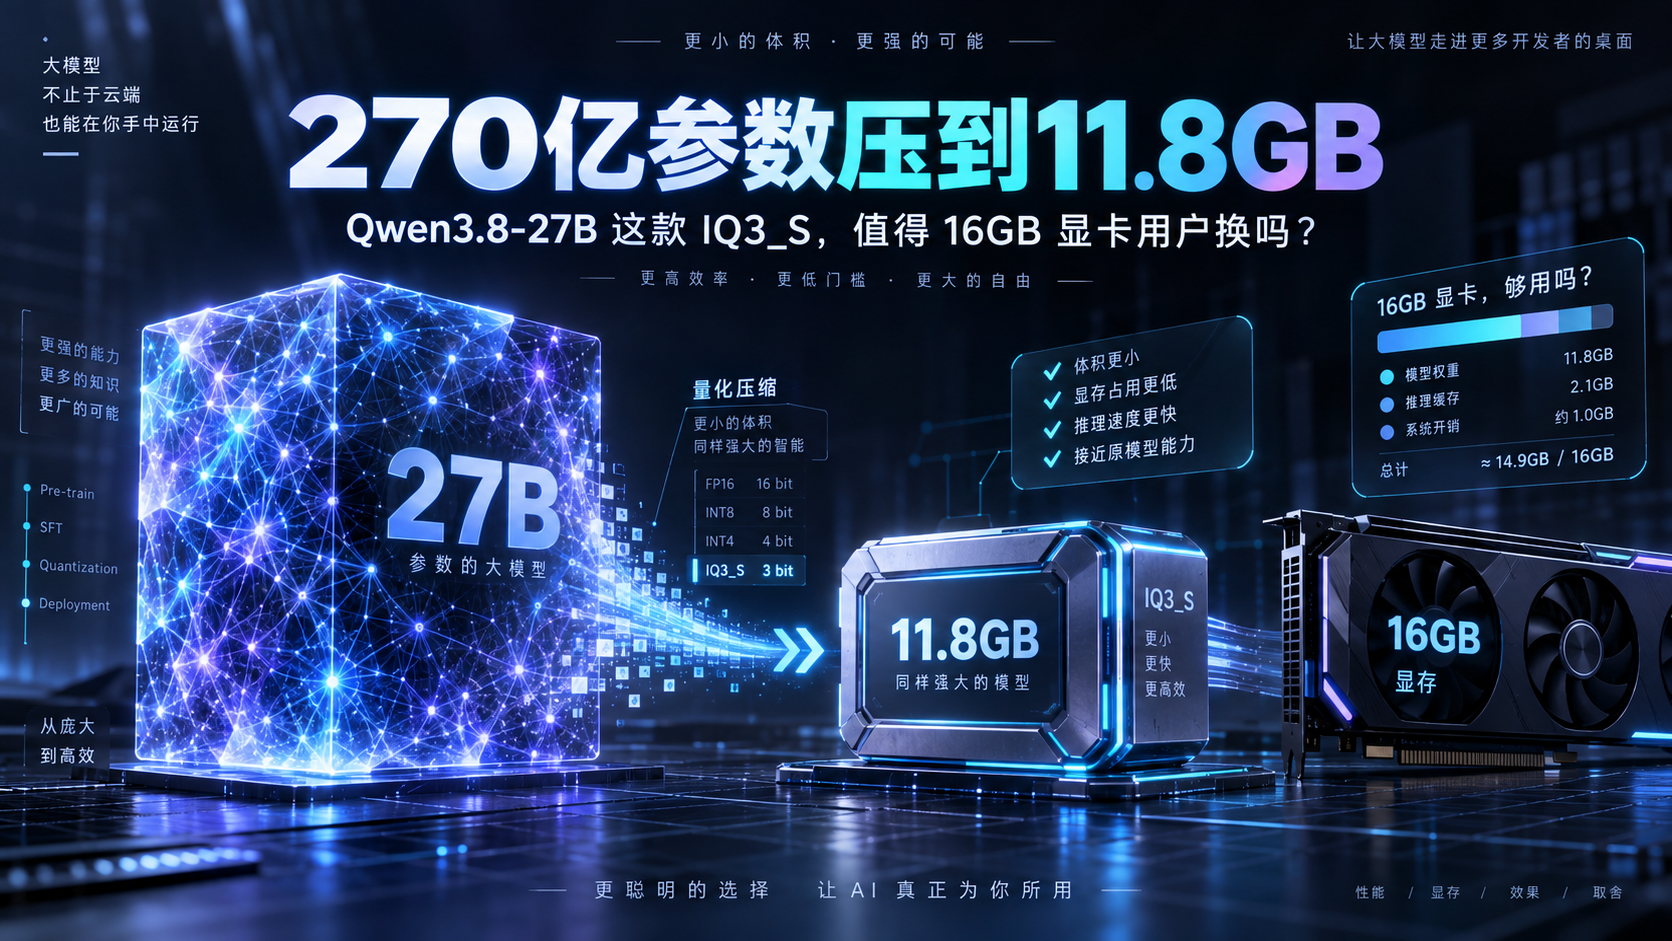 270亿参数压到11.8GB:Qwen3.8-27B这款IQ3_S,值得16GB显卡用户换吗?
奥地利 ISTA 团队把量化精度按张量重新分配,推出11.8GB的GSQ-RCO IQ3_S。它在发布方部分测试中接近BF16,但并非全面无损;本文核对四个IQ3文件、MTP开销与真实跑分,说明16GB显卡用户该比较什么。IQ3_S于9月1日加入仓库,本文于9月14日复核,不是近五天首发。
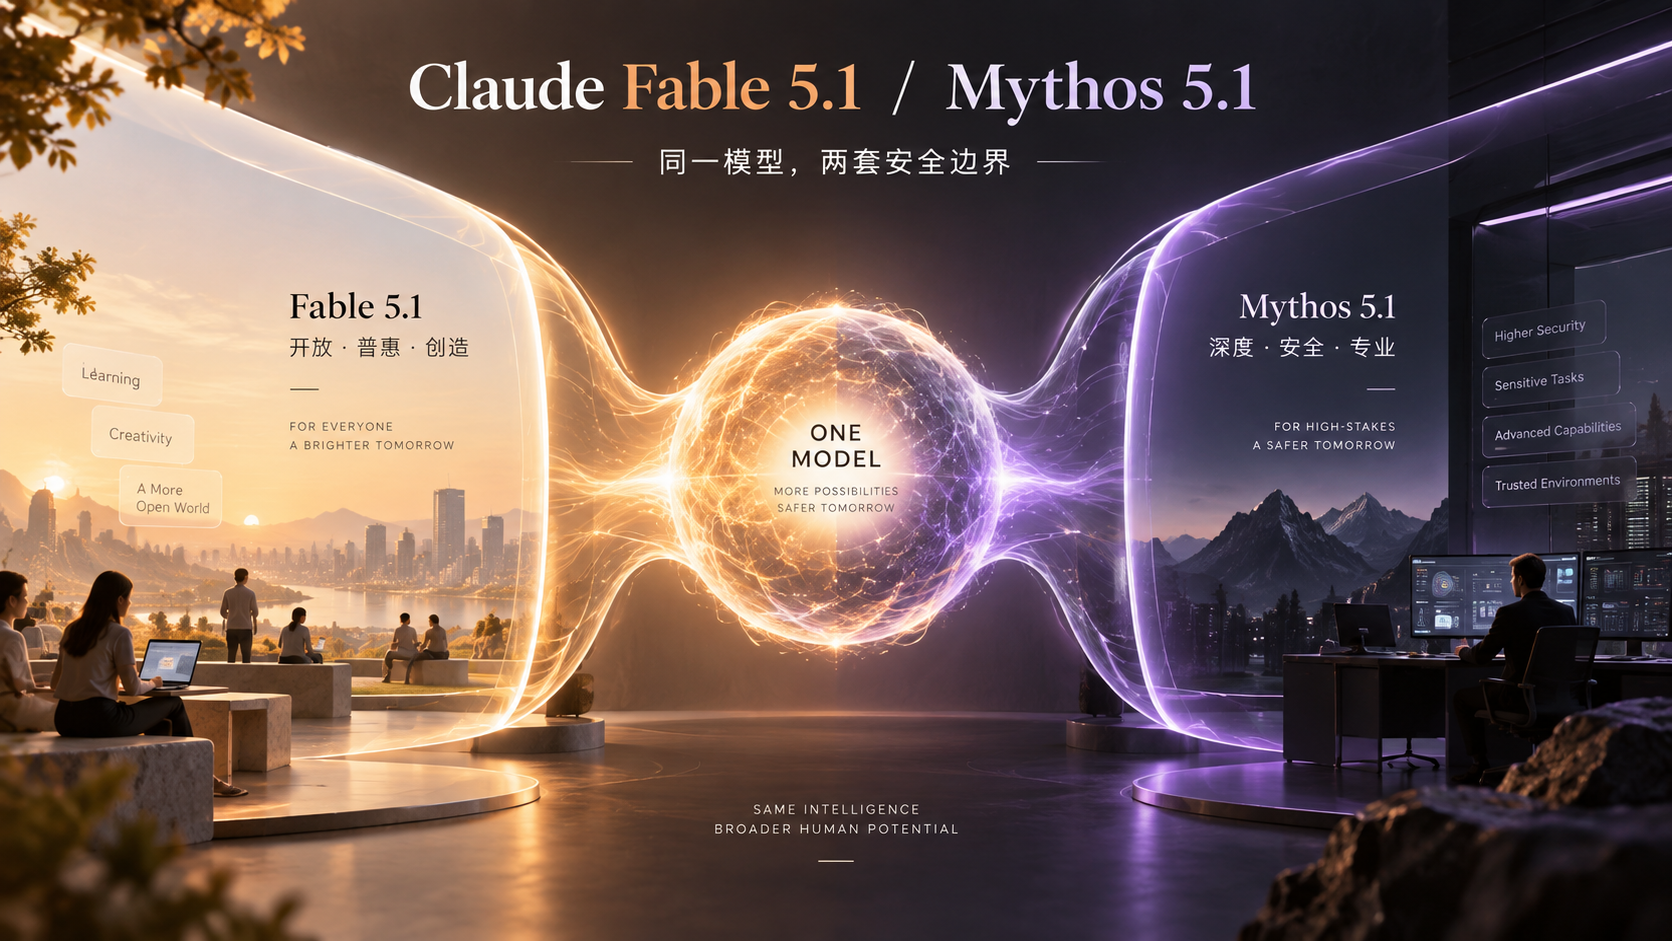 Claude Fable 5.1 与 Mythos 5.1:同一个模型、两套安全边界,Anthropic 开始分层开放前沿能力
Anthropic 同时发布 Claude Fable 5.1 与 Mythos 5.1。两者是同一个底层模型,真正的差异在安全护栏与 Trusted Access:Fable 面向一般用户,Mythos 为经过审核的网络安全与生命科学场景开放更高权限能力。
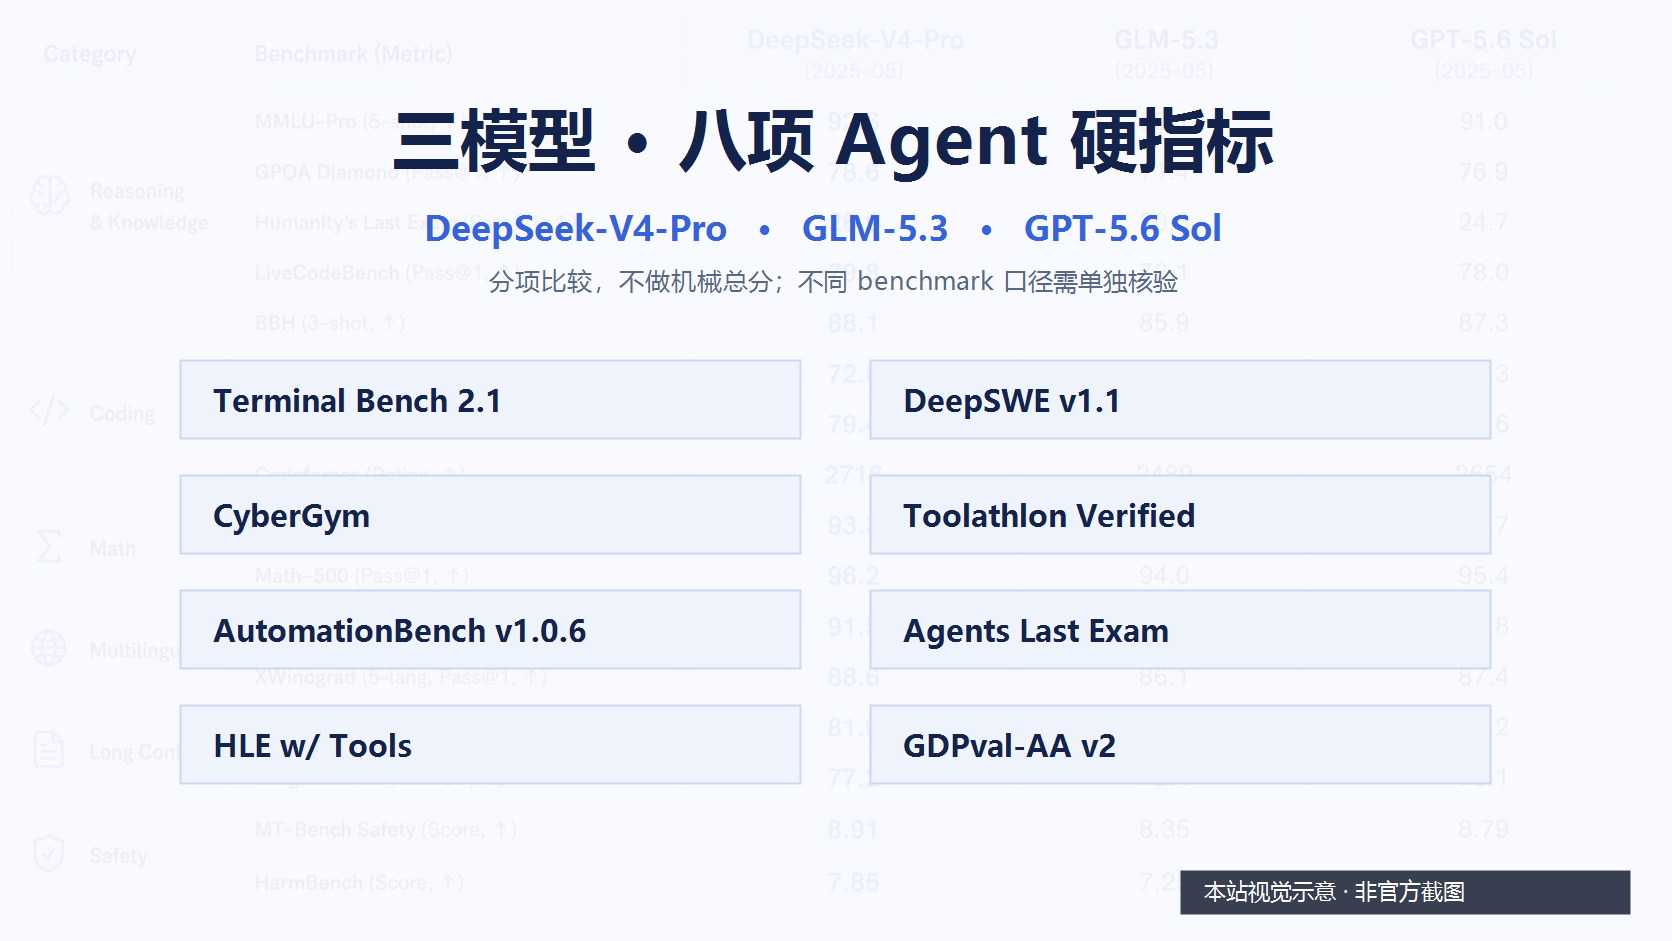 DeepSeek-V4-Pro、GLM-5.3、GPT-5.6 Sol:用八项硬指标做三模型测评
以终端、长程代码、安全、工具调用、自动化、专业工作、工具增强推理与职业任务八项硬指标比较三款模型;逐项标注图表数值与一手发布材料的口径边界。