

 配音不一定要上云:audio.cpp 让普通电脑能做什么?
audio.cpp把配音、转写和音源分离接到共同入口,并降低部分模型的资源开销。但约6GB显存、CPU提速与中文效果各有条件。结合项目文档,拆解可迁移的内容工作、模型选择与成品交付边界。
AI 工具与开源生态动态
AI 工具、模型与开源生态的资料整理与解读,低成本建立持续判断力
配音不一定要上云:audio.cpp 让普通电脑能做什么?
audio.cpp把配音、转写和音源分离接到共同入口,并降低部分模型的资源开销。但约6GB显存、CPU提速与中文效果各有条件。结合项目文档,拆解可迁移的内容工作、模型选择与成品交付边界。
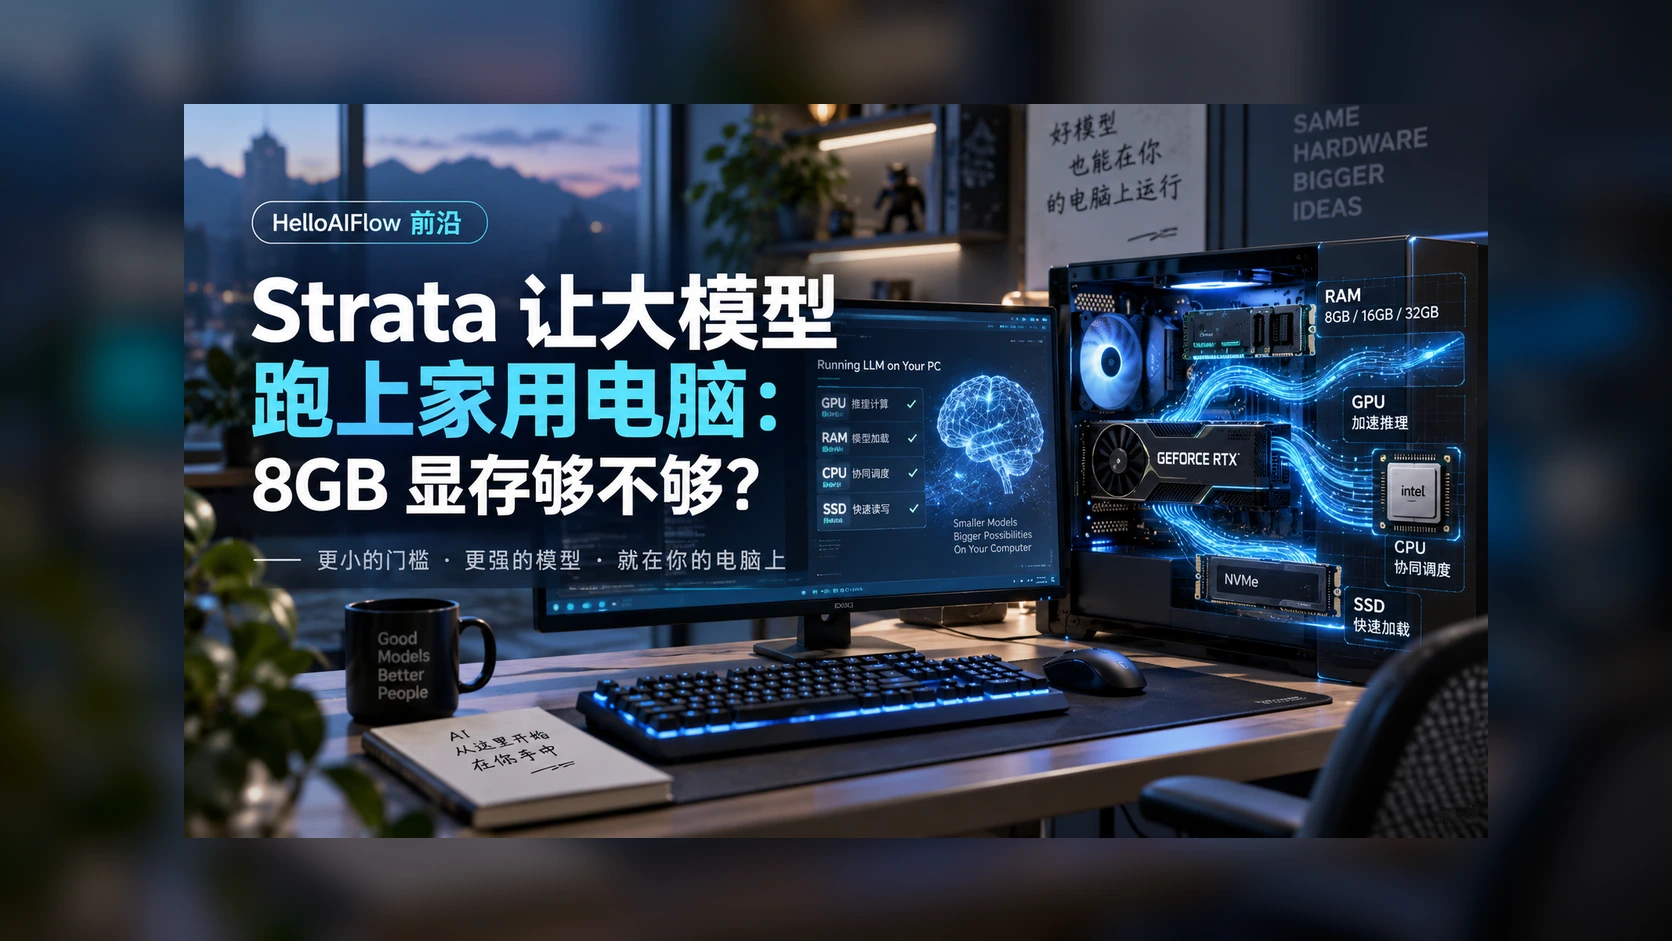 Strata 让大模型跑上家用电脑:8GB 显存够不够?
从 Strata 仓库中标为 9 月 29 日的速度记录出发,先分清 8GB 可运行与 12GB 测试成绩,再解释显卡、内存和处理器如何分工,以及 128K 长输入、量化和代码裁剪版的取舍。
 本地模型还能快多少?ExLlamaV3 1.5 先省下一次内存搬运
ExLlamaV3 是帮助在自己电脑上运行 AI 大模型的工具,负责加载模型和安排计算。先弄清它在本地 AI 中的作用,再看 1.5 版本如何减少内存搬运、改善等待时间。
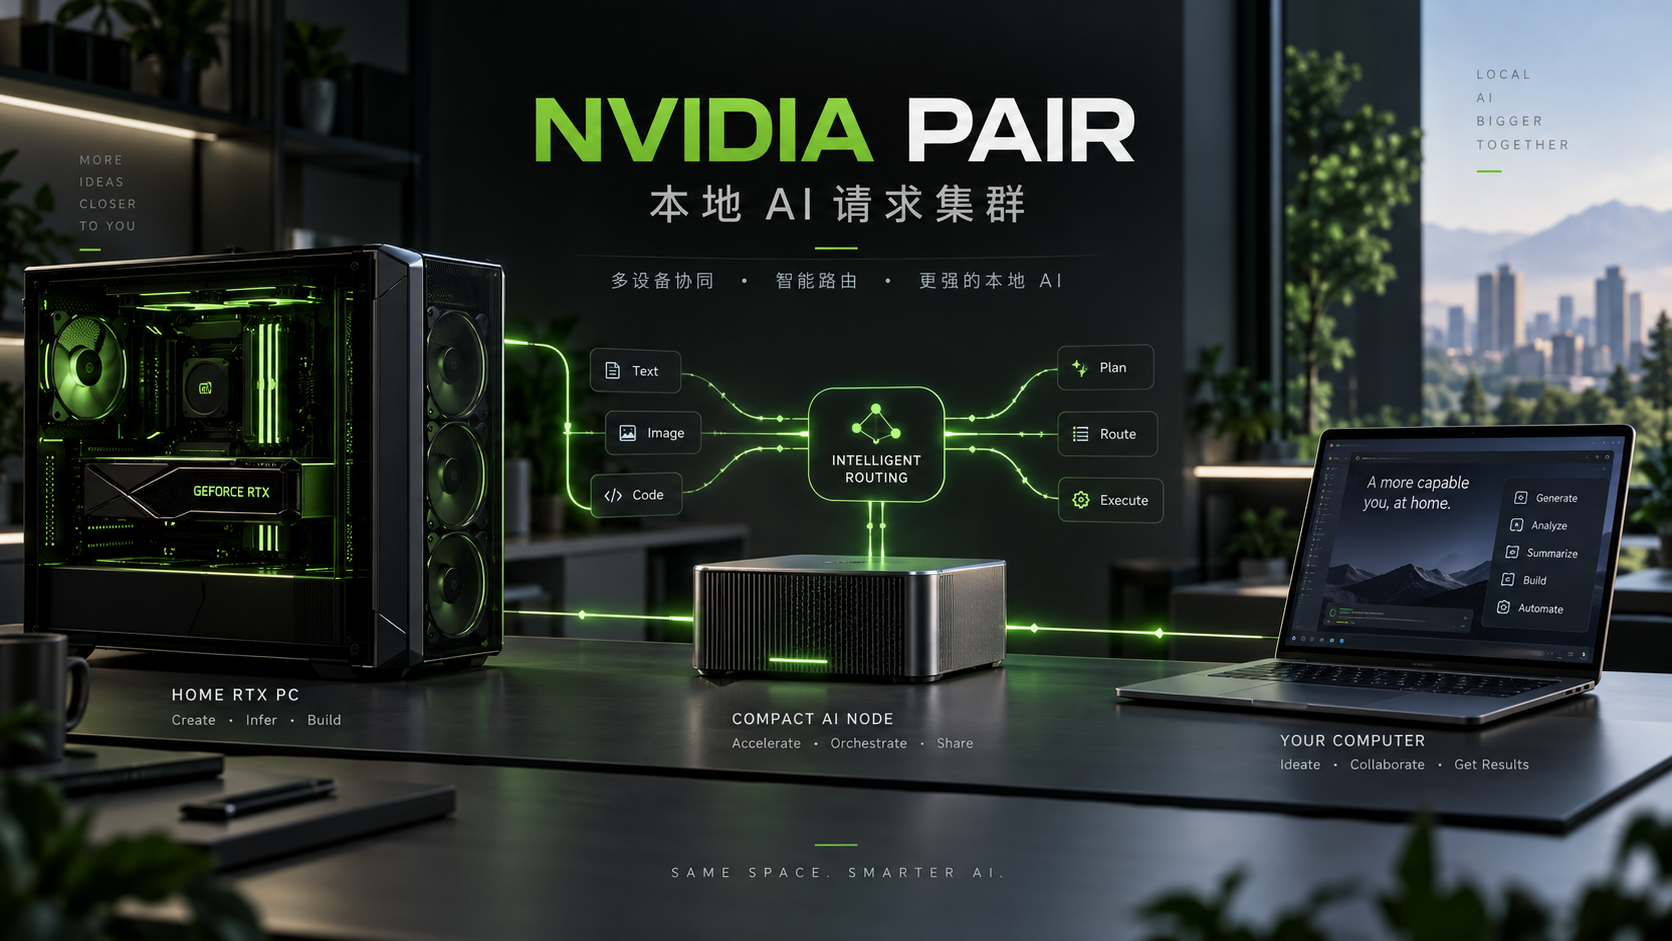 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。
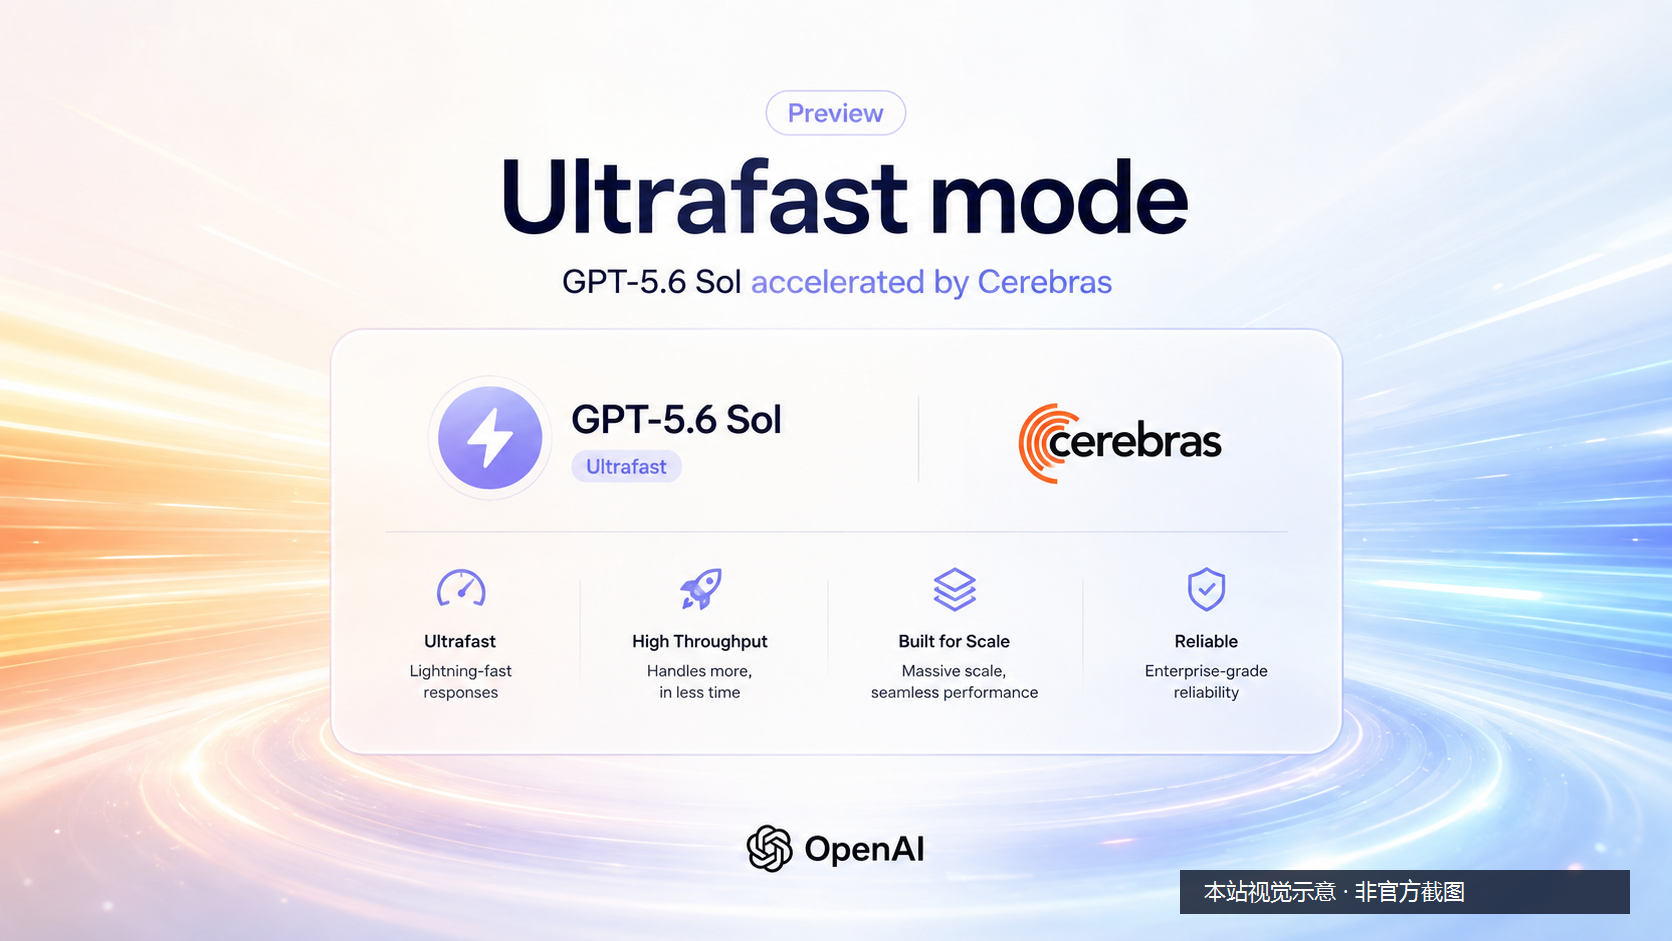 OpenAI 预览 Ultrafast 模式:GPT-5.6 Sol 提速最高 14 倍,由 Cerebras 驱动
2026-08-13,OpenAI 预览 Ultrafast 服务层级,可在 API 中把 GPT-5.6 Sol 的运行速度提升至标准处理的 14 倍,由 Cerebras 提供支持,每秒最多生成 750 个输出 token。它面向应急响应、实时客服、金融研究与商务等对秒级响应敏感的场景,目前仅对限定的早期客户开放有限预览。
 MCP 2026-07-28 转向无状态:GitHub Server 提前适配了什么
MCP 2026-07-28 稳定规范移除了协议会话与 initialize 握手,把连接上下文放回每次请求;GitHub MCP Server 的提前适配展示了无状态服务的工程收益,也说明兼容仍依赖版本协商、旧协议回退和一致性测试。
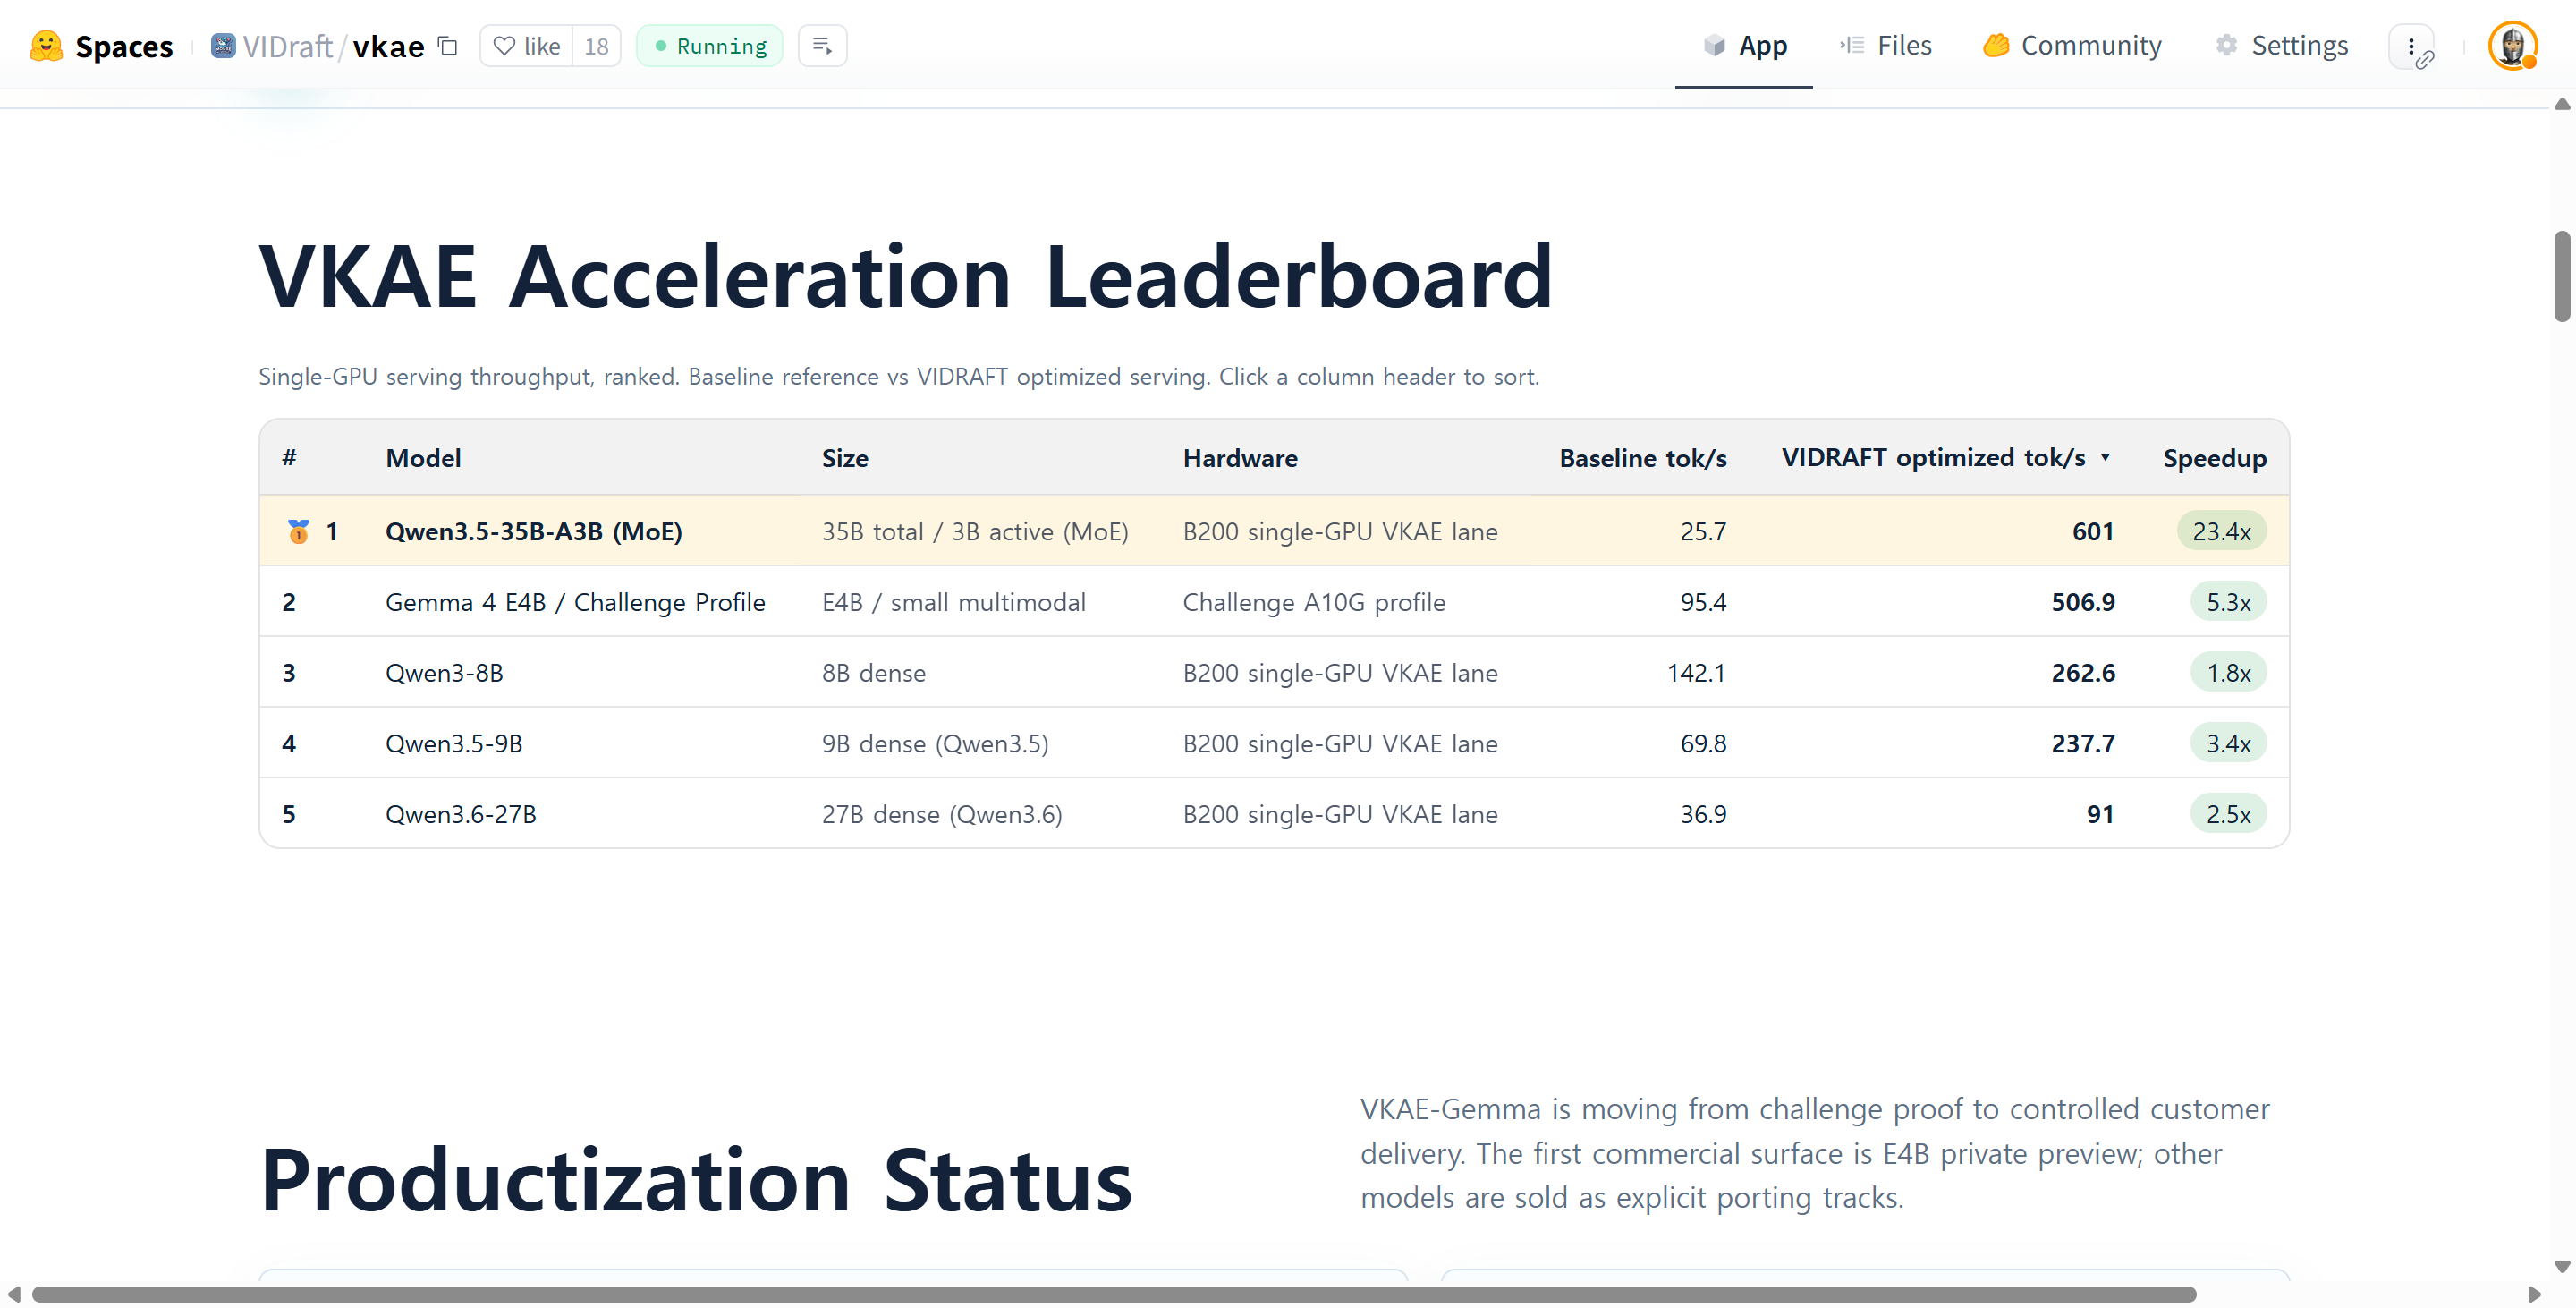 韩国 FINAL-Bench 展示 VKAE 推理加速:同一块 B200 上让 MoE 模型吞吐提升到 23.4 倍
韩国团队 VIDRAFT / FINAL-Bench 在 Hugging Face 发布 VKAE 推理加速结果,强调训练只发生一次,推理才是 AI 服务持续成本。文章给出了可复现实验入口和 Docker 容器,对 AI 基础设施运营很有参考价值。