Meta Muse Spark 1.3:工具调用少 20%、Token 少 25%,长程 Agent 的“效率”开始不能只看 Token 单价
Meta 发布 Muse Spark 1.3,把长程 Agent 的重点从“会不会调用工具”推进到“是否知道何时澄清、何时求助、何时确认、何时少走无效轮次”。Meta 工程师内部对比称工具调用减少约 20%、Token 减少约 25%,但第三方评测提醒:这些节省不能直接外推到所有任务。
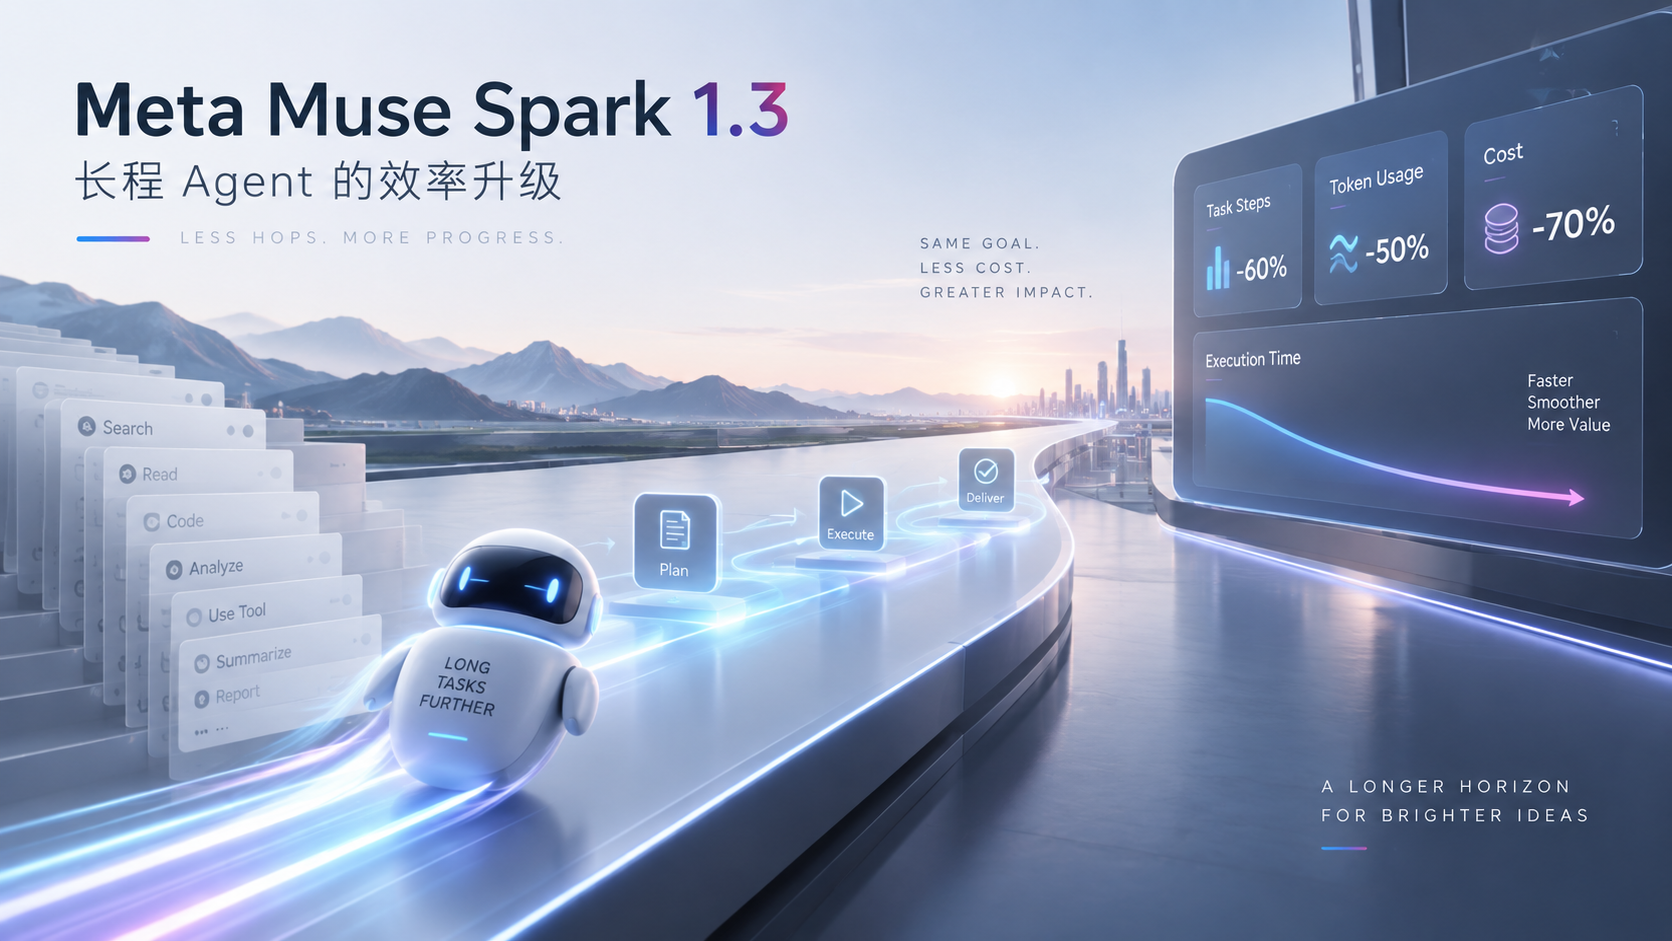
Meta 在 2026 年 9 月 2 日发布 Muse Spark 1.3,并在 Muse Code 与 Meta Model API 上线。相比一次单纯的 coding benchmark 刷新,这次更值得关注的是 Meta 对 long-horizon agentic workflows 的训练目标:模型需要在一个很长的线程里同时维护多项工作,从混乱甚至互相冲突的资料中构建上下文,发现计划缺口后主动修正,并最终交付结果。Meta AI Research 发布说明
Meta 工程师给出了一组很抓眼球的内部比较:相对 Muse Spark 1.2,1.3 在他们的 coding workflow 中约使用 20% 更少的 tool calls、25% 更少的 tokens。但这组数字真正有价值的地方,不是把“Token 少 25%”理解成账单必然下降 25%,而是它提示了一个正在变化的 Agent 评价维度:效率开始取决于模型是否会减少无意义的轮次,而不只是每百万 Token 的单价。
这次优化的不是“会不会用工具”,而是 Agent Loop 的纪律
Meta 对 Muse Spark 1.3 的行为描述很具体。当任务含糊时,模型更倾向于向用户提澄清问题;遇到自己解决不了的障碍时,会主动请求帮助;在执行 consequential actions 或不可逆操作前,会先向用户确认。Meta 发布说明
把这些行为放到一个长程工作流里看,它们并不是“聊天更礼貌”,而是 Agent Loop 的控制策略:
- Ambiguous → Clarify:避免一开始理解错目标,后面几十轮全部返工。
- Blocked → Ask for help:避免模型在缺权限、缺资料或能力不足时继续虚构进展。
- Consequential → Confirm:把真正高风险的动作留给用户做最后确认。
- No need → Fewer turns:不需要额外轮次时,尽量不要为了“显得在思考”重复调用工具。
Meta 还称 1.3 更能在单一长线程中区分用户插入的新任务、旧任务的继续指令和跨任务上下文。这类能力很难用一个静态知识问答分数完整描述,但对持续工作数小时的 Agent 来说,往往直接决定最终完成率。
“少 20% Tool Calls、少 25% Token”只代表一类工作流
Meta 对效率数字写得很谨慎:它来自 comparisons by Meta engineers。换句话说,这是厂商在自己的工程工作流与 harness 下看到的结果,而不是一个可以直接套用到任意 Agent 的通用系数。Meta 发布说明
第三方数据也说明了为什么要保留这个边界。Artificial Analysis 的 Muse Spark 1.3 xhigh 页面把公开 xhigh 变体的 Intelligence Index 评为 61,并给出约 0.55 美元 / Intelligence Index task 的综合任务成本。它采用的是自己的固定任务集和统一 harness,而不是 Meta 工程师的内部 coding workflow。
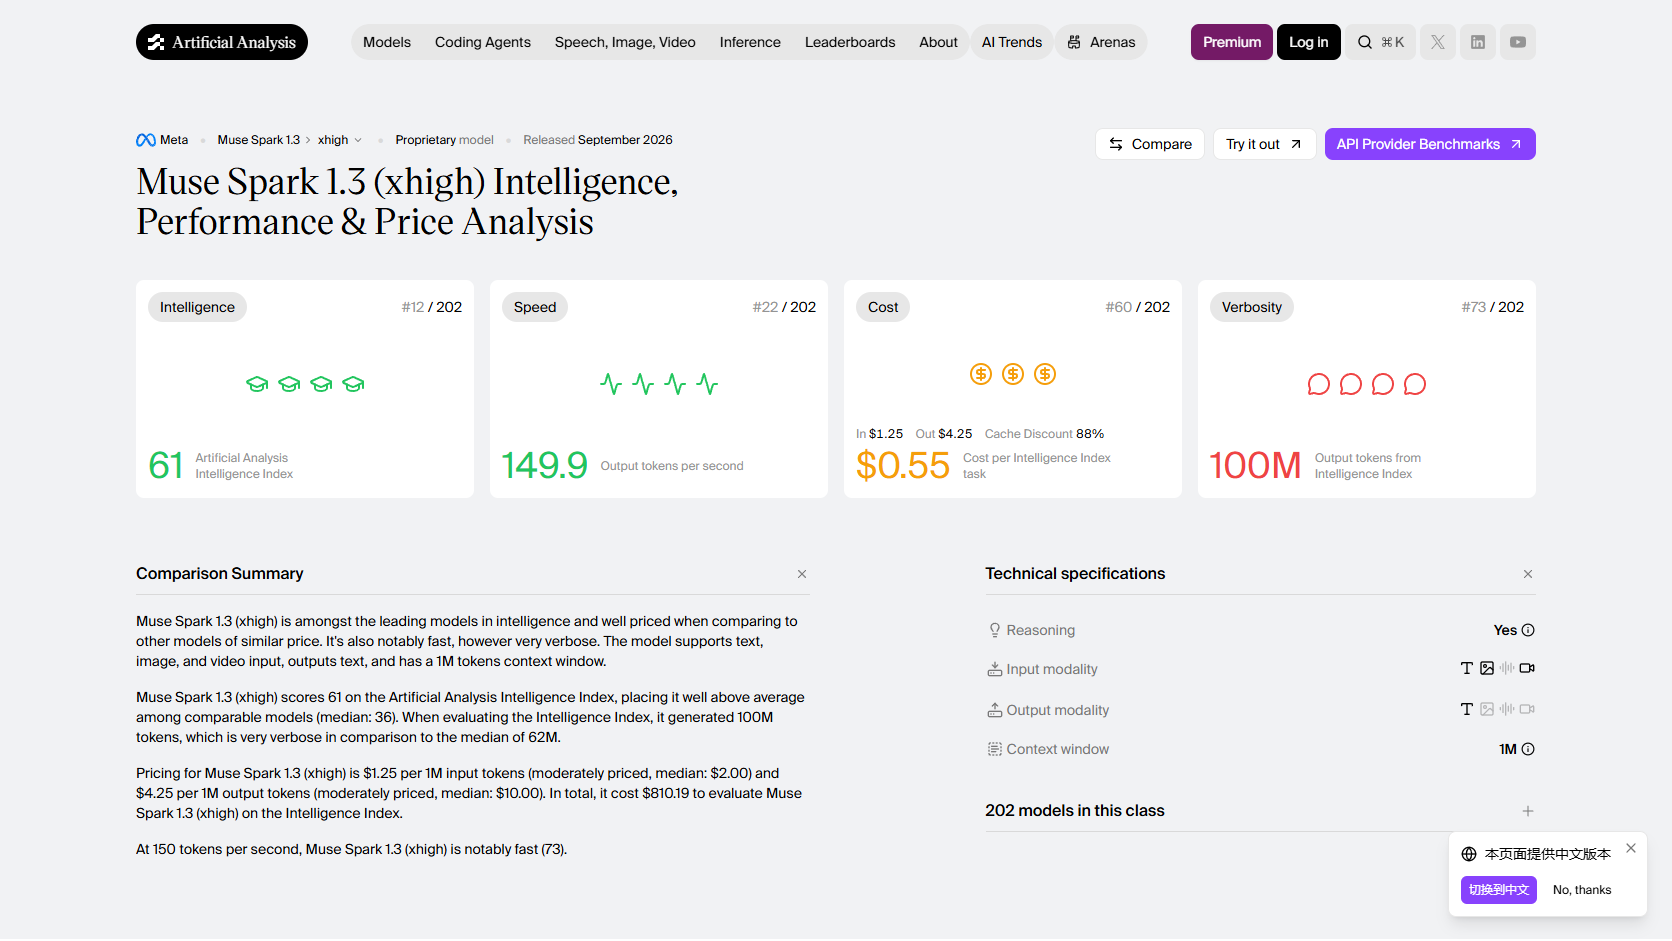
因此,两个结果并不矛盾:一个模型可以在真实 coding workflow 里因为少走无效轮次而节省工具调用,同时在另一套更难、更固定的独立任务上投入更多推理或上下文。对生产 Agent 来说,真正该测的是:
完成同一项真实任务需要多少轮、多少次工具调用、多少 Token、多少人工接管,以及最终是否一次交付成功。
只比较输入 / 输出单价,已经越来越难解释 Agent 的真实成本。
Muse Spark 1.3 更像“会管理自己的不确定性”
Meta 还强调 1.3 对自身能力和限制的认识更好:知道自己会什么、不会什么、知道什么时候遇到了障碍,而不是继续 hallucinate outcomes。Meta 发布说明
这与传统 benchmark 的区别在于,长程 Agent 的失败经常不是“某道题不会”,而是:
- 一开始误解需求却一直执行;
- 工具返回异常后没有停下来;
- 已经丢失关键约束却继续生成;
- 高风险操作没有确认;
- 做完后没有判断结果是否真正满足交付条件。
如果 1.3 的训练确实能减少这些行为,那么它的价值会更多体现在返工率和中途人工接管次数,而不仅是每秒输出多少 Token。
Max Reasoning 发布时还没有一般开放
Muse Spark 1.3 发布时,Meta 表示此前已有的 reasoning modes 可以使用,但 max reasoning 仍要等额外安全测试完成后再开放。Meta 发布说明
Artificial Analysis 的发布分析已经测试到 limited preview 的 max 变体,并给出 Intelligence Index 62;公开 xhigh 为 61。这两项不能被混成“开发者现在已经能稳定调用 62 分版本”。如果后续 Meta 正式开放 max,文章中的 availability 和评测口径也需要同步更新。
Open Weights 仍在 Roadmap,不是已经开源
Meta 在发布页最后提到未来会有更大的模型,以及 Muse Spark open weights release。但截至这次发布,Muse Spark 1.3 仍是通过 Muse Code 和 Meta Model API 使用的模型,开放权重只是 roadmap。Meta 发布说明
这也是为什么“Meta 又回到开放模型路线”现在还不能作为事实结论。更准确的说法是:Meta 已经公开承诺权重发布方向,但时间和具体版本还没有在本次发布中落地。
长程 Agent 的效率,应该看“完成一次工作”的总成本
Muse Spark 1.3 最值得学习的变化,是 Meta 把效率从模型推理速度扩展到了 Agent 行为:少走不必要的轮次、知道何时问、何时停、何时确认,以及能否在长线程里保持任务边界。
对实际选型来说,20% fewer tool calls / 25% fewer tokens 可以作为一个值得复测的信号,但不能直接当成成本承诺。未来评价一个生产 Agent,更合理的指标可能不是“每百万 Token 多少钱”,而是:一个完整任务从开始到验收,需要多少 Token、多少工具调用、多少分钟、多少次人工介入,以及成功率是多少。
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。
 Qwen3.8-Flash-Next每秒70词元?本地加速之前,先看模型究竟改了什么
同样叫Flash-Next,70词元/秒背后可能是另一条计算路径:每词元激活专家从10减到5,再训练共享专家补偿。本文对照单台DGX Spark的两套原始资料,拆开量化、MTP、输入速度、输出速度和并发吞吐,不把128GB统一内存结果套到16GB显卡。
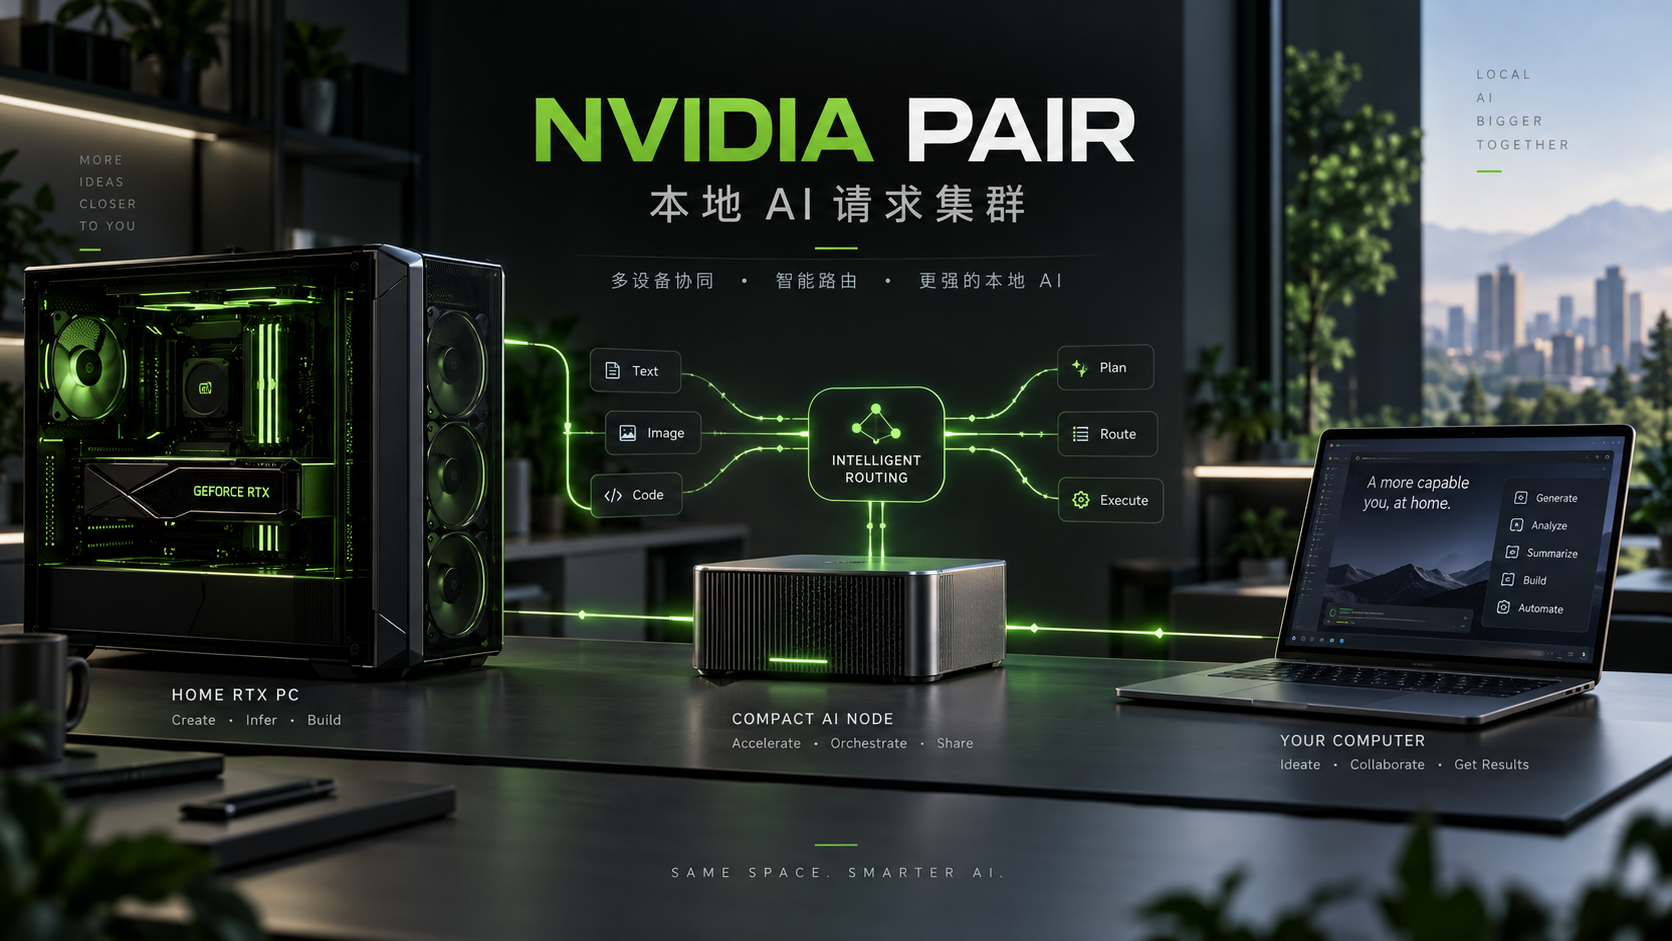 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。