DeepSeek-V4-Pro 正式版上线:Agent 能力提升之外,还应怎样读独立测评
DeepSeek-V4-Pro GA 新增 Responses API 与 Codex 适配,并公布了多项 Agent 分数;但这些属于厂商自报。本文补入 NIST/CAISI 与公开 AgentRE-Bench 的独立证据,说明它们评测的版本、脚手架、预算与未能覆盖的 GA 增量,帮助团队把“官方能力声明”与“可迁移的选型证据”分开。
2026 年 8 月 13 日,DeepSeek API 更新日志宣布 deepseek-v4-pro 的 GA 版本在 APP、Web 与 API 上线,并称 DeepSWE 为 62.7、Terminal Bench 2.1 为 87.9,同时原生支持 Responses API、适配 Codex。这里首先要区分两层证据:这些是厂商针对 GA 版本给出的能力声明;能否迁移到团队自己的 Agent 工作流,还要看独立评测的模型版本、脚手架和预算是否相同。
官方分数说明了发布方向,但不是独立复测
官方发布把重点放在代码、终端与工具调用等 Agent 场景,并保留 deepseek-v4-pro 这一模型名。Responses API 与 Codex 适配是接口与集成能力的变化;它能减少接入转换,但不能单凭接口兼容推出修复成功率、长任务稳定性或成本已经同步提升。Codex 的具体接入要求仍应以 DeepSeek Codex 接入文档为准,thinking 强度的实际取舍也应按 Thinking Mode 文档做本地任务集验证。
因此,DeepSWE 62.7、Terminal Bench 2.1 87.9 等数值在本文只作为厂商公布的 GA 结果保留:目前没有找到以 8 月 13 日 GA 快照、相同版本号和相同推理设置为对象的可复核第三方复测。不能把较早版本的外部结果直接当成对这些 GA 分数的验证或反驳。
NIST/CAISI 给出的是较早 V4-Pro 的独立基线
NIST 的 CAISI 独立评估在 2026 年 4 月测试了开源权重版 DeepSeek V4 Pro,而非 8 月的 GA API 更新。它使用九项基准、包含半私有数据与内部软件工程测试;对 Agent 相关设置,CAISI 使用 Inspect 的 ReAct agent,并为 PortBench、CTF-Archive-Diamond 和 SWE-Bench Verified 设定不同的加权 token 预算。
在该独立设置下,V4 Pro(max)在 SWE-Bench Verified 为 74%,PortBench 为 44%,整体 IRT 估计 Elo 为 800 ± 28。CAISI 同时指出,SWE-Bench 的分数会受到系统提示、脚手架与 token 预算影响,且其结果通常低于其他评测方的数字。这不是“谁的分数更真”的简单结论,而是提醒选型者:模型、工具循环、上下文上限和成功判定一起构成 Agent 成绩。
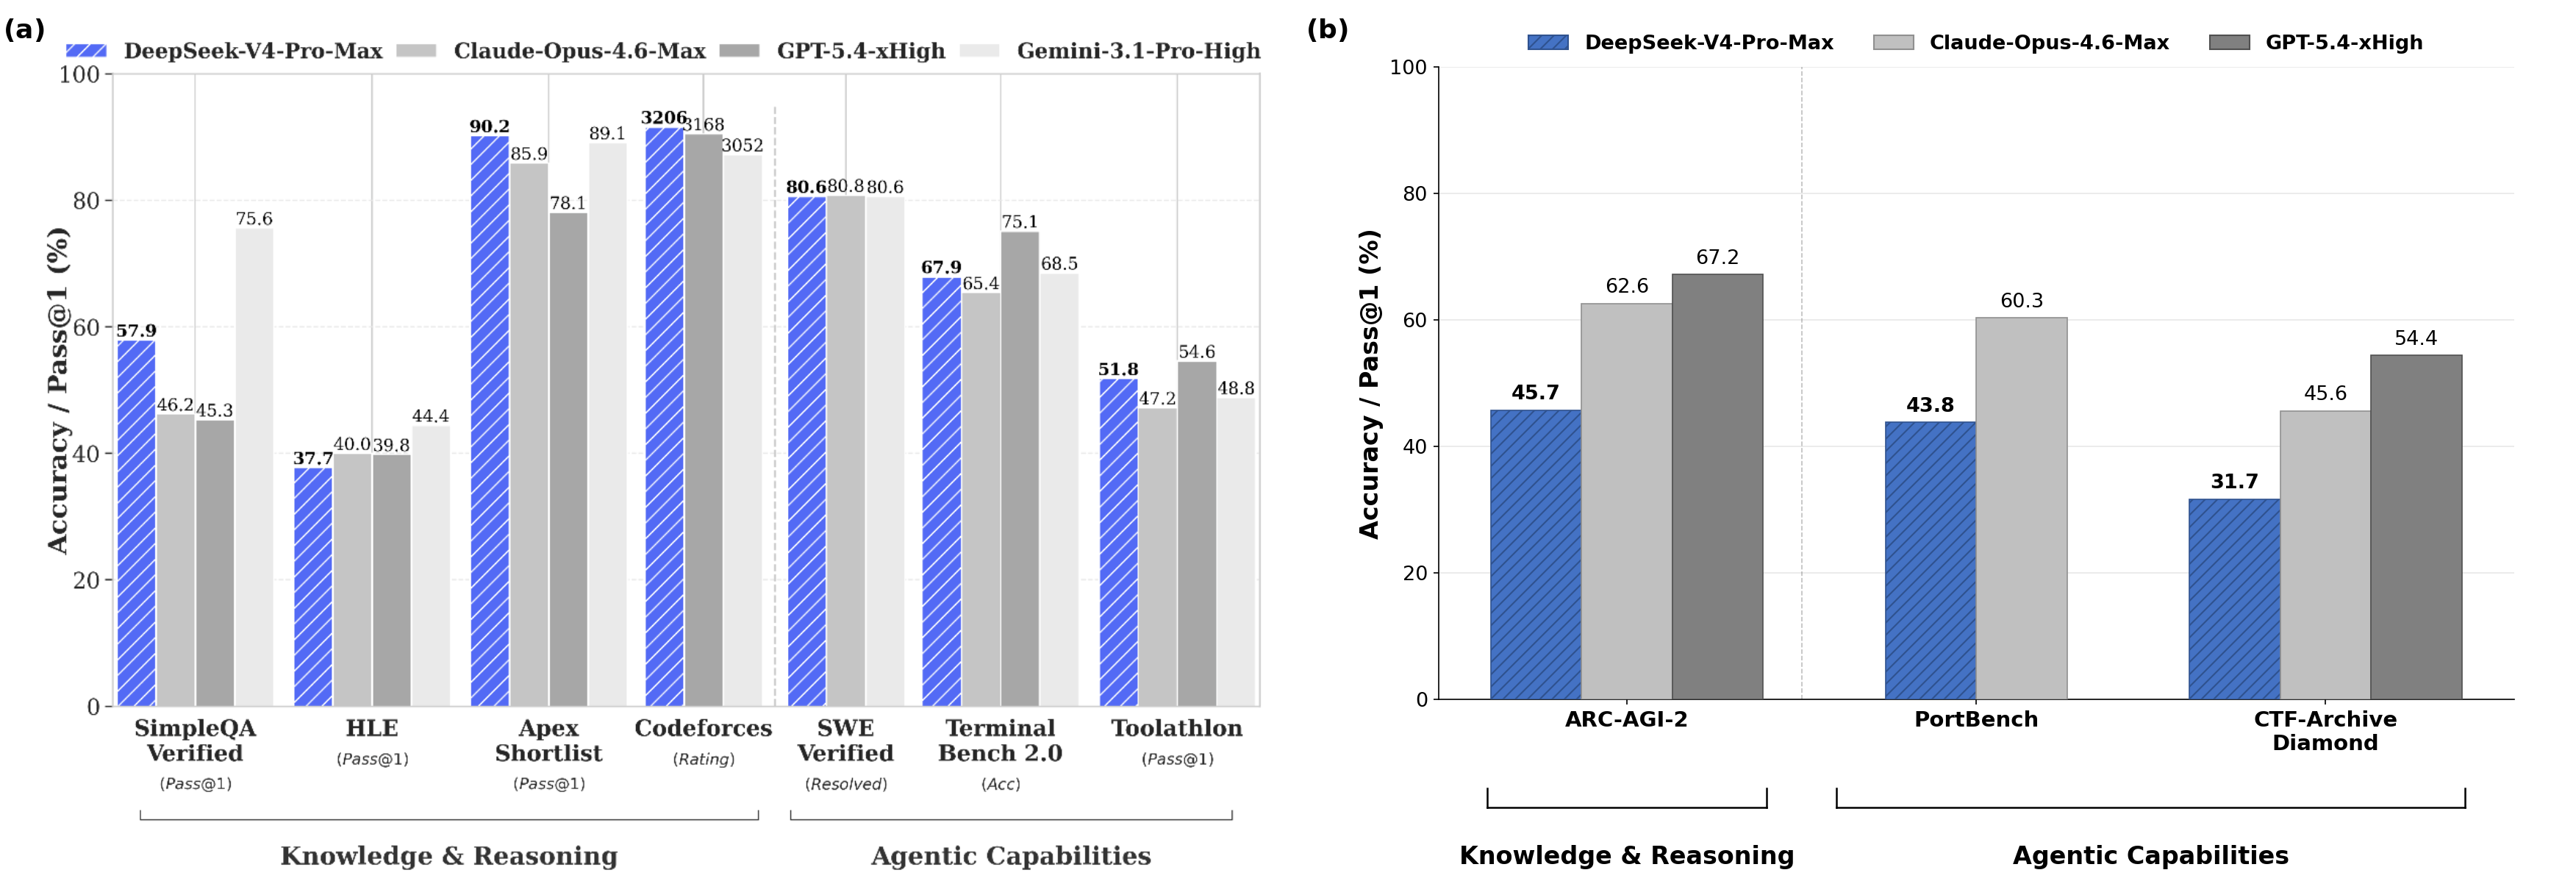
*图:NIST/CAISI 将 DeepSeek 自报基准与其预先设定的评估套件并列,展示不同基准选择会改变相对结论。图源:NIST / CAISI 独立评估,不是 DeepSeek GA 版本的复测图。*
公开 AgentRE-Bench 补充了运行代价与失败方式
AgentRE-Bench 的公开运行分析以 deepseek-v4-pro 的 thinking 模式运行 13 个二进制逆向分析任务,报告总分 0.648、完成 10/13 个任务、平均每任务 12.4 次工具调用;同时记录三个任务受到提供方超时影响。该项目公开了模型配置、harness 改动和运行命令,因而可作为一个可追溯的外部场景信号。
但它不是通用 Agent 排行榜:任务数量小、场景集中,且部分空结果仍进入评分默认值。它最有价值的地方不是证明 V4-Pro“最强”,而是暴露了实际集成中必须处理的条件——thinking trace 在多轮调用中需要正确回传,短暂的提供方超时也会影响端到端完成率。文章不据此推导网络安全操作能力,也不提供任务复现或攻击步骤。
对 Responses API 接入团队的可执行判断
GA 的价值可以先按“接入便利性”验证,再按“任务结果”验证。第一步确认 Responses API、Codex 适配与现有工具调用、上下文回传是否兼容;第二步用团队自己的真实 issue、终端任务或审批流,在固定时间、token 上限、重试策略和成功判定下,对比旧版本。至少记录完成率、人工接管率、每任务 token、端到端时延与失败原因。
这样既不会把 DeepSeek 的最新官方数字误当独立结论,也不会因为较早版本的外部评测而忽略 GA 的实际更新。现有外部证据支持把 V4-Pro 放入候选集,但不足以替代针对具体工作流的回归测试。
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。
 Qwen3.8-Flash-Next每秒70词元?本地加速之前,先看模型究竟改了什么
同样叫Flash-Next,70词元/秒背后可能是另一条计算路径:每词元激活专家从10减到5,再训练共享专家补偿。本文对照单台DGX Spark的两套原始资料,拆开量化、MTP、输入速度、输出速度和并发吞吐,不把128GB统一内存结果套到16GB显卡。
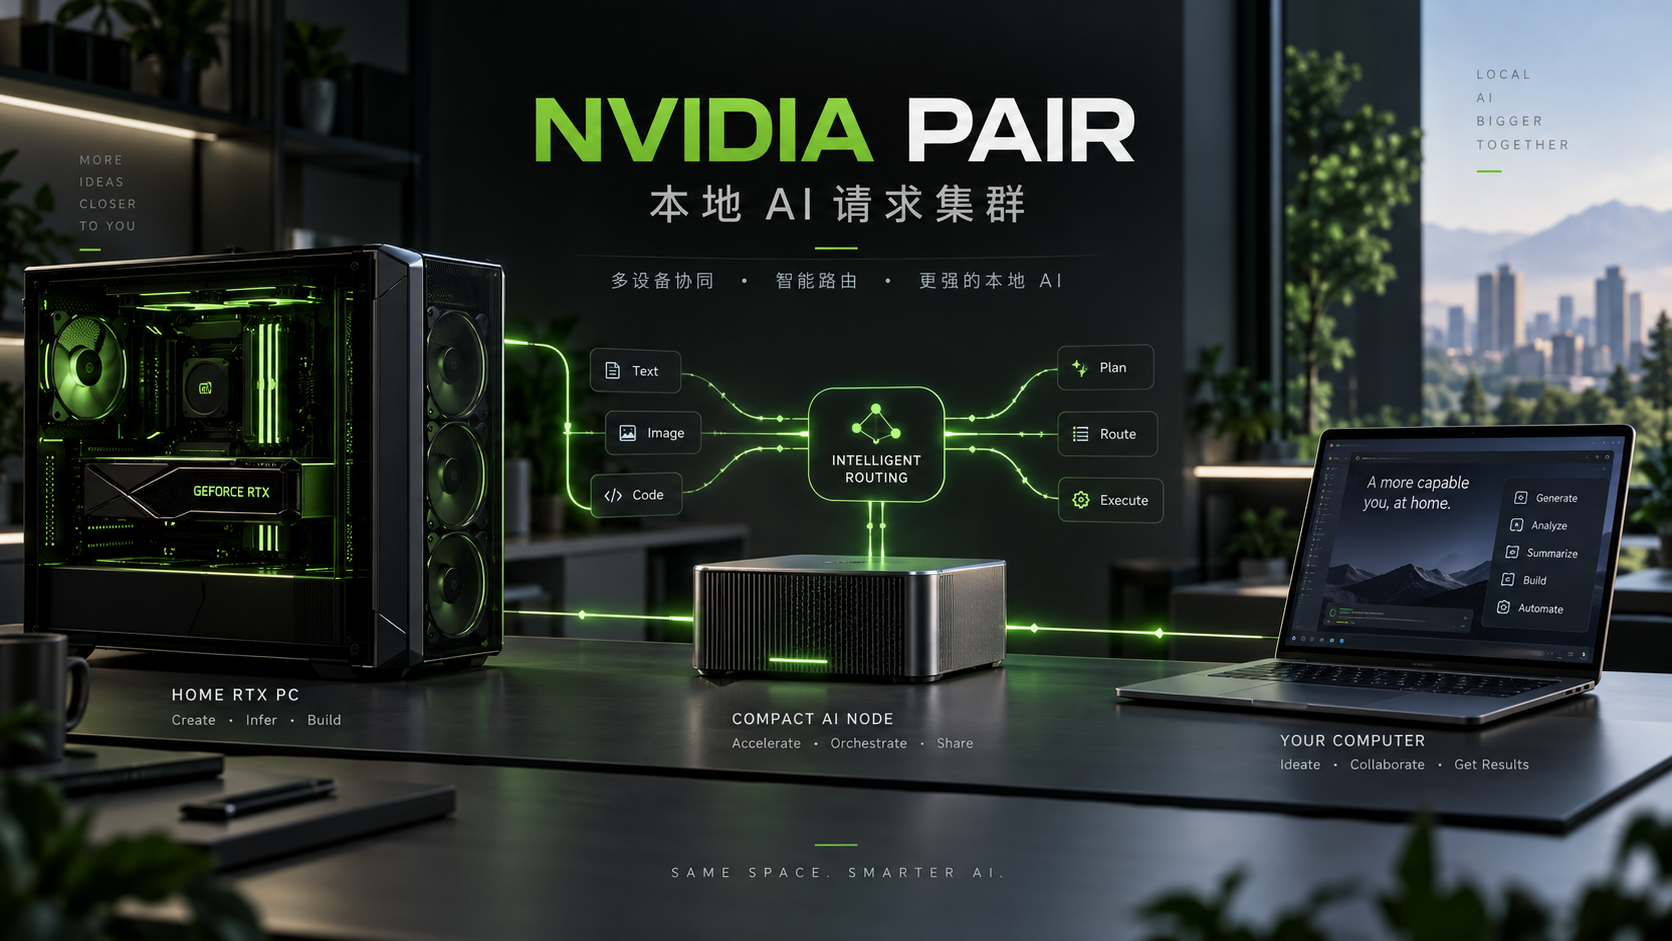 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。