DeepSeek-V4-Pro、GLM-5.3、GPT-5.6 Sol:用八项硬指标做三模型测评
以终端、长程代码、安全、工具调用、自动化、专业工作、工具增强推理与职业任务八项硬指标比较三款模型;逐项标注图表数值与一手发布材料的口径边界。
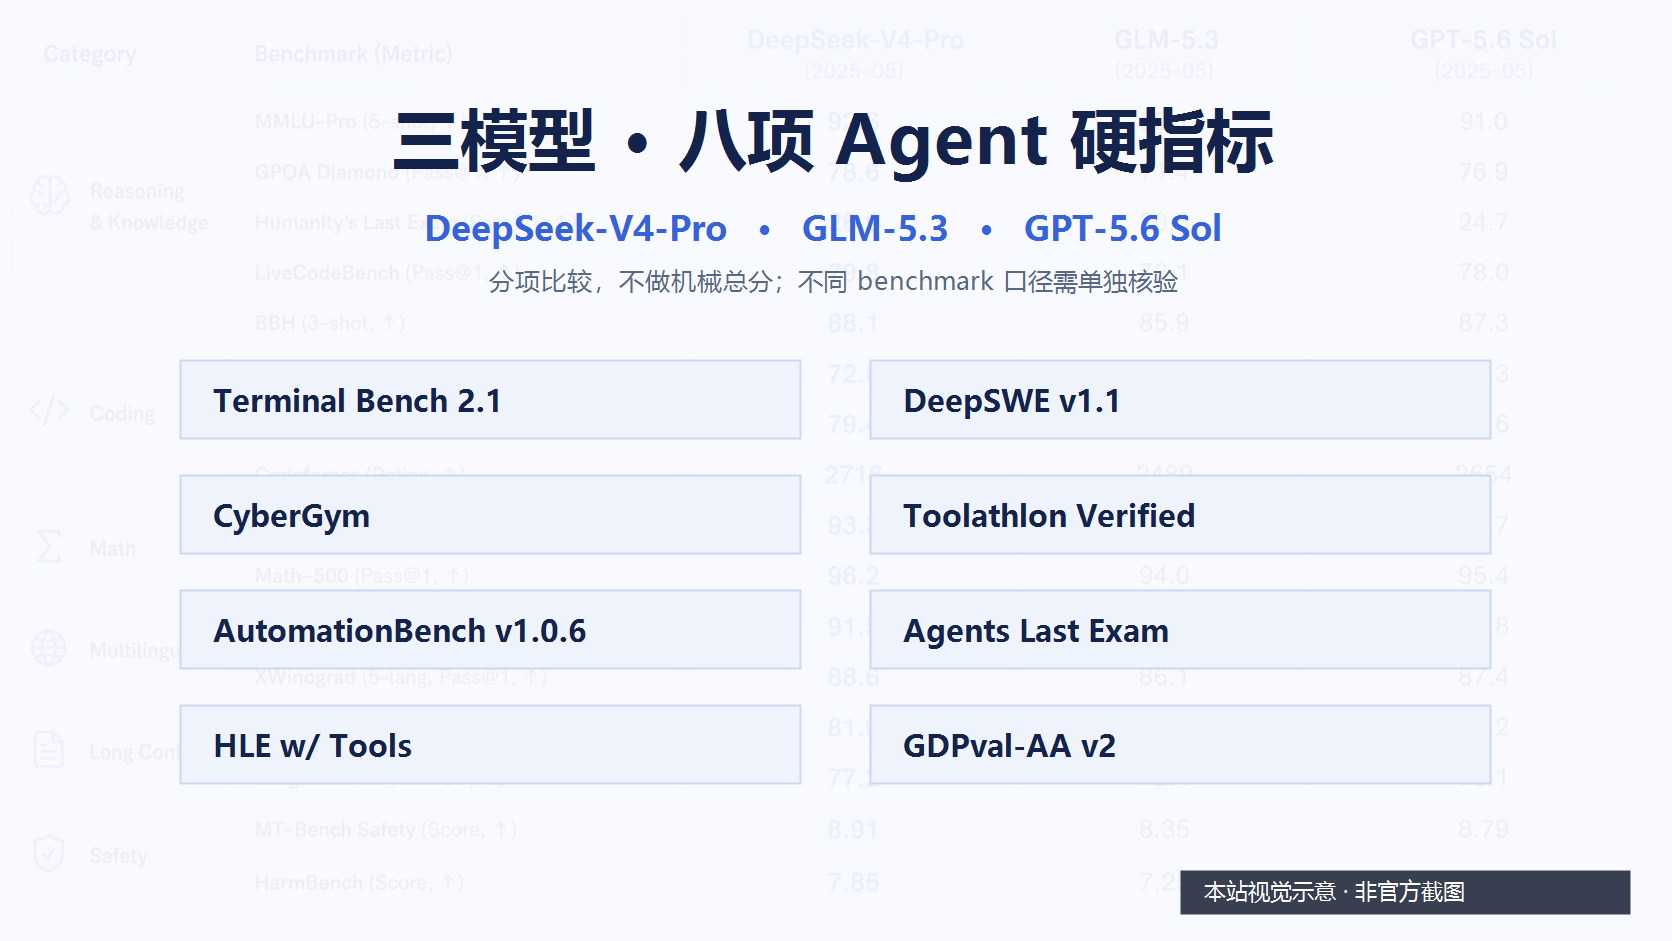
这篇测评只看模型在 Agent 任务上的八项硬指标:Terminal Bench 2.1、DeepSWE v1.1、CyberGym、Toolathlon Verified、AutomationBench v1.0.6、Agents’ Last Exam、HLE w/ Tools、GDPval-AA v2。它们分别覆盖终端执行、长程代码修复、网络安全、工具调用、业务自动化、长程专业任务、工具增强推理与职业型知识工作,比“综合智力分”更贴近 Agent 选型。
需要先说明边界:这八项并非来自同一组织、同一 harness、同一推理强度或同一日期;因此不能把百分比与 Elo 机械平均成一个“总冠军”。本文采用“领先 / 接近 / 暂不计分”三种结论,并把厂商披露和独立材料分开。
八项硬指标分别测什么
| 指标 | 它实际衡量的能力 | 对团队意味着什么 |
|---|---|---|
| Terminal Bench 2.1 | 在终端中执行多步骤任务、读写文件、运行命令与修正错误 | 代码 Agent 能否完成真实 CLI 工作流 |
| DeepSWE v1.1 | 在真实代码库中理解问题、修改代码并通过验证 | 长程软件工程与缺陷修复能力 |
| CyberGym | 在未修复代码库中复现漏洞 PoC | 安全 Agent 的代码理解与攻击面推理能力 |
| Toolathlon Verified | 多工具选择、参数调用、状态传递与结果校验 | 工具调用是否稳定而不是只会“说会调用” |
| AutomationBench v1.0.6 | 跨业务工具完成端到端自动化 | 运营、销售、支持与内部流程自动化能力 |
| Agents’ Last Exam | 专业领域的长程工作流 | 模型能否长期保持任务目标与交付质量 |
| HLE w/ Tools | 高难知识问题中主动使用外部工具 | 深度研究、检索和复杂推理的上限 |
| GDPval-AA v2 | 有经济价值的职业任务的盲评表现 | 文档、分析、交付物等知识工作质量 |
八项结果对照:先看分项胜负,不做伪精确总分
下表按王鹏先生提供的信息图列出的模型版本和八个维度整理。它适合作为本轮比较的问题清单,但不是可直接平均的统一榜单:图中有些数值与当前可访问的一手发布页不一致,后文会单独标出。
| Benchmark | GLM-5.3 | DeepSeek V4 Pro 0813 | GPT-5.6 Sol | 读法 |
|---|---|---|---|---|
| Terminal Bench 2.1 | 88.2 | 87.9 | 88.8 | 三者差距不足 1 分,判为接近,不据此定胜负 |
| DeepSWE v1.1 | 66.9 | 62.7 | 72.7 | GPT 在长程代码修复上优势最清晰 |
| CyberGym | 84.5 | 83.3 | 83.6 | 三者均高;GLM 的领先很小,须看运行条件 |
| Toolathlon Verified | 73.0 | 74.1 | 74.9 | 三者都接近,GPT 略高,不构成工具链碾压 |
| AutomationBench v1.0.6 | 48.2 | 43.2 | 45.8 | 图中 GLM 领先;DeepSeek 数值与 GA 发布页不一致,暂不计分 |
| Agents’ Last Exam | 28.5 | 25.7 | 28.6 | 图中 GPT 与 GLM 几乎相同;GPT 官方页使用了不同设置的 52.7,暂不计分 |
| HLE w/ Tools | 62.5 | 60.0 | 64.5 | GPT 领先,DeepSeek 官方 GA 也披露了 60.0 |
| GDPval-AA v2 | 1769 | 1590 | 1730 | 图中 GLM 领先;GPT 官方发布表为 1747.8,口径冲突,暂不计分 |
DeepSeek 的 GA 更新可直接核验其中六项:Terminal Bench 87.9、DeepSWE 62.7、CyberGym 83.3、Toolathlon 74.1、Agents’ Last Exam 25.7、HLE w/ Tools 60.0;但它同时列出 AutomationBench(Public)为 31.8,而非图中 43.2。这说明至少 AutomationBench 混入了不同版本、私有集或运行配置,不能作为横向结论。DeepSeek V4-Pro GA 更新与测试口径
GPT-5.6 Sol 的官方发布材料支持 Terminal Bench 88.8、DeepSWE 72.7,以及其在 Coding Agent Index 的 80 分;该页还把 Agents’ Last Exam 报为 52.7、GDPval-AA v2 报为 1747.8。这与图中 28.6、1730 不同,表明至少这两行不是同一推理强度、评测版本或评分呈现方式。OpenAI GPT-5.6 发布页 GPT-5.6 Sol 模型页
GLM-5.3 的 84.5 CyberGym 由 Axios 报道为 Z.ai 披露值,且 Z.ai 因安全评估暂时只向选定安全合作方开放。因此它可作为 GLM 在安全 Agent 上的强信号,但不是对全部八项的独立复测背书。Axios 对 GLM-5.3 受控发布和 CyberGym 的核验
编码、终端和工具:GPT 领先,DeepSeek 紧跟,GLM 不能只凭一行分数下结论
从 Terminal Bench、DeepSWE 与 Toolathlon 三项看,GPT-5.6 Sol 的优势来自 DeepSWE:72.7 对 66.9 和 62.7,说明它在长程代码库任务上更有把握。Terminal Bench 的 88.8、88.2、87.9 则过于接近,更多说明三者都已进入高水平区间,而不是可据此断言某款模型的终端 Agent 稳定胜出。OpenAI 还明确说明其 max 与多 Agent ultra 会改变能力、成本和时延边界;比较时必须固定为单 Agent 还是多 Agent、以及哪一档推理强度。OpenAI 对推理强度和多 Agent 设置的说明
DeepSeek-V4-Pro 的信号是“可竞争而不是全胜”:它在官方 GA 条目中将代码 Agent 任务固定为 max effort,并披露了上述多项得分;同时原生支持 Responses API、面向 Codex 适配。对于已有 Codex 或 OpenAI 兼容调用链的团队,重点应验证真实仓库中的完成率与回归率,而不是只比较 Terminal Bench 的小数点差距。DeepSeek V4-Pro GA 更新与测试口径
安全、自动化与专业工作:GLM 有两个高点,但证据成熟度最低
CyberGym 评测的是在历史漏洞代码库中生成可工作的复现 PoC,包含 1,507 个实例和 188 个项目;其官方说明同时提醒 Agent 运行具有随机性,较小的分差未必有实际意义。图中的 84.5、83.6、83.3 只能说明三者均须按照高能力安全 Agent 对待,不能把 0.9–1.2 分差放大成安全能力代差。CyberGym 方法与局限
GLM-5.3 在 AutomationBench 与 GDPval-AA v2 的图中数字最高,意味着它值得进入“业务自动化 + 职业知识工作”的候选名单;但在公开模型 ID、通用 API 条件、测试 harness 和可复跑材料未齐备前,这两个领先只能记为厂商口径的候选结论。相较之下,GPT-5.6 Sol 的公开资料对长程专业工作更完整:Agents’ Last Exam 的设计覆盖 55 个专业领域,但它与信息图中的数字口径不同,不能混为一行。Agents’ Last Exam 的任务范围
测评结论:按八项能力选模型,而不是按单一“总分”选模型
- 复杂编码与长程代码 Agent:GPT-5.6 Sol 优先。 DeepSWE 的领先最明显,Terminal、Toolathlon 和 HLE w/ Tools 也处于领先或接近领先位置;代价是必须把推理档位、多 Agent 数量与工具权限写入成本账本。
- 终端、工具调用和高性价比工程链:DeepSeek-V4-Pro 进入第一候选。 它在八项中没有明显短板,且官方 GA 已明确版本、推理档位和 Agent 测试条件;但 AutomationBench 的冲突提醒团队不能只拿汇总海报做采购判断。
- 安全 Agent 与职业型自动化探索:GLM-5.3 值得受控评估。 CyberGym 的厂商披露领先、图中 AutomationBench 与 GDPval-AA v2 也有高点;但当前受控发布状态意味着它还不适合被写成可全面替换的通用生产基座。
最终建议不是给三者再编一个总分,而是建立八行验收表:每个模型固定版本、推理档位、Agent harness、工具权限、最大步数与预算;每一行至少重复三次,并保留原始日志。只有这样,图中“八项硬碰硬”才会成为可采购、可复核的测评,而不是一张难以追溯口径的对比海报。
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。
 Qwen3.8-Flash-Next每秒70词元?本地加速之前,先看模型究竟改了什么
同样叫Flash-Next,70词元/秒背后可能是另一条计算路径:每词元激活专家从10减到5,再训练共享专家补偿。本文对照单台DGX Spark的两套原始资料,拆开量化、MTP、输入速度、输出速度和并发吞吐,不把128GB统一内存结果套到16GB显卡。
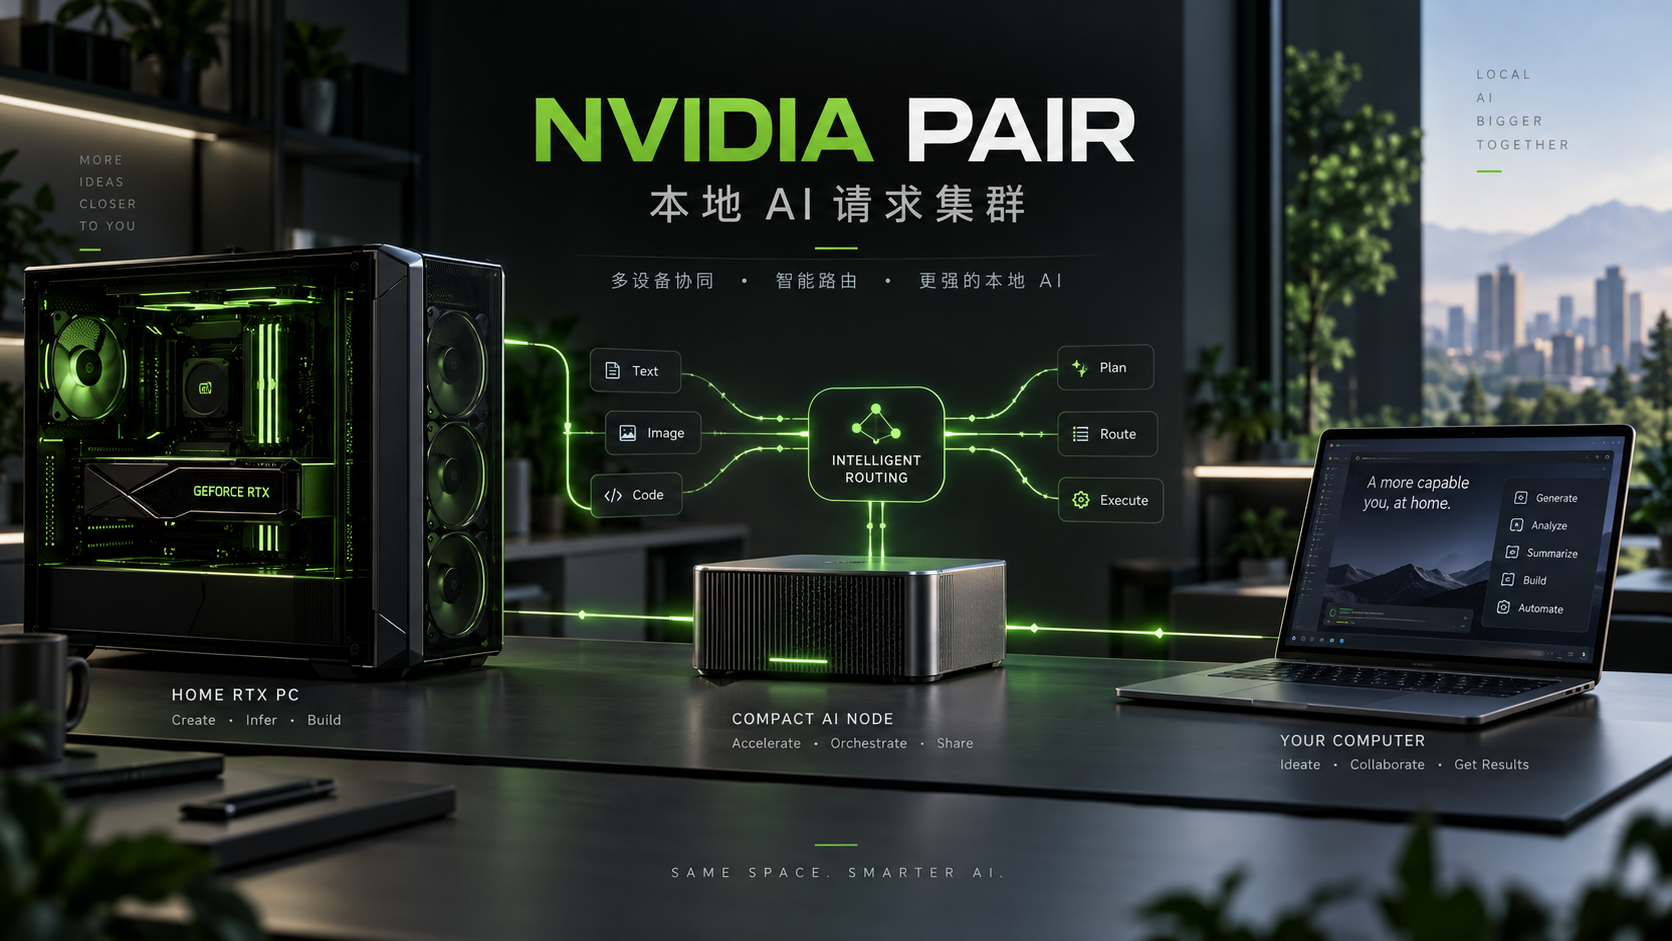 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。