Codex 总在翻整份代码?Serena 能让它少走多少弯路
Serena能按函数和引用关系为Codex取代码,但“省90% token”缺少统一对测依据。结合官方案例,看默认LSP与JetBrains后端的能力差异、接入步骤,以及哪些任务原生工具更省事。
只想改一个按钮的保存逻辑,Codex却先读了几份大文件,又沿着搜索结果往回找。代码还没改几行,会话已经很长。做原型时,这通常只是等得久;项目越做越大,就开始影响额度和判断:真正有关的函数,被无关实现、注释和旧结果挤在一起。
10月20日,一条关于Serena的讨论把“token消耗降低90%”推到了台前。这个数字很诱人,但更值得看的,是它给Codex补了一套找代码的方法:按函数、类和引用关系取内容。它通过MCP接入,提供代码检索与编辑工具,任务怎么拆、代码怎么写,仍由模型决定。原帖、Serena官方仓库
别先读全文件,先找到要改的函数
假设要修复“保存后偶尔没有提示”。有用的背景可能只有保存函数、调用它的按钮,以及返回结果的处理方式。把整个页面文件读进来当然能找到答案,但顺手带入的表格、样式和其他弹框,对这次修改未必有帮助。
Serena把这段过程拆成几个有明确目标的动作:先用get_symbols_overview看文件里有哪些符号;知道名字后,用find_symbol读取指定函数体;需要确认影响范围,再用find_referencing_symbols查谁调用了它。这里的“符号”可以理解为有身份的函数、类或方法,不只是碰巧出现同一串文字。官方工具与能力说明
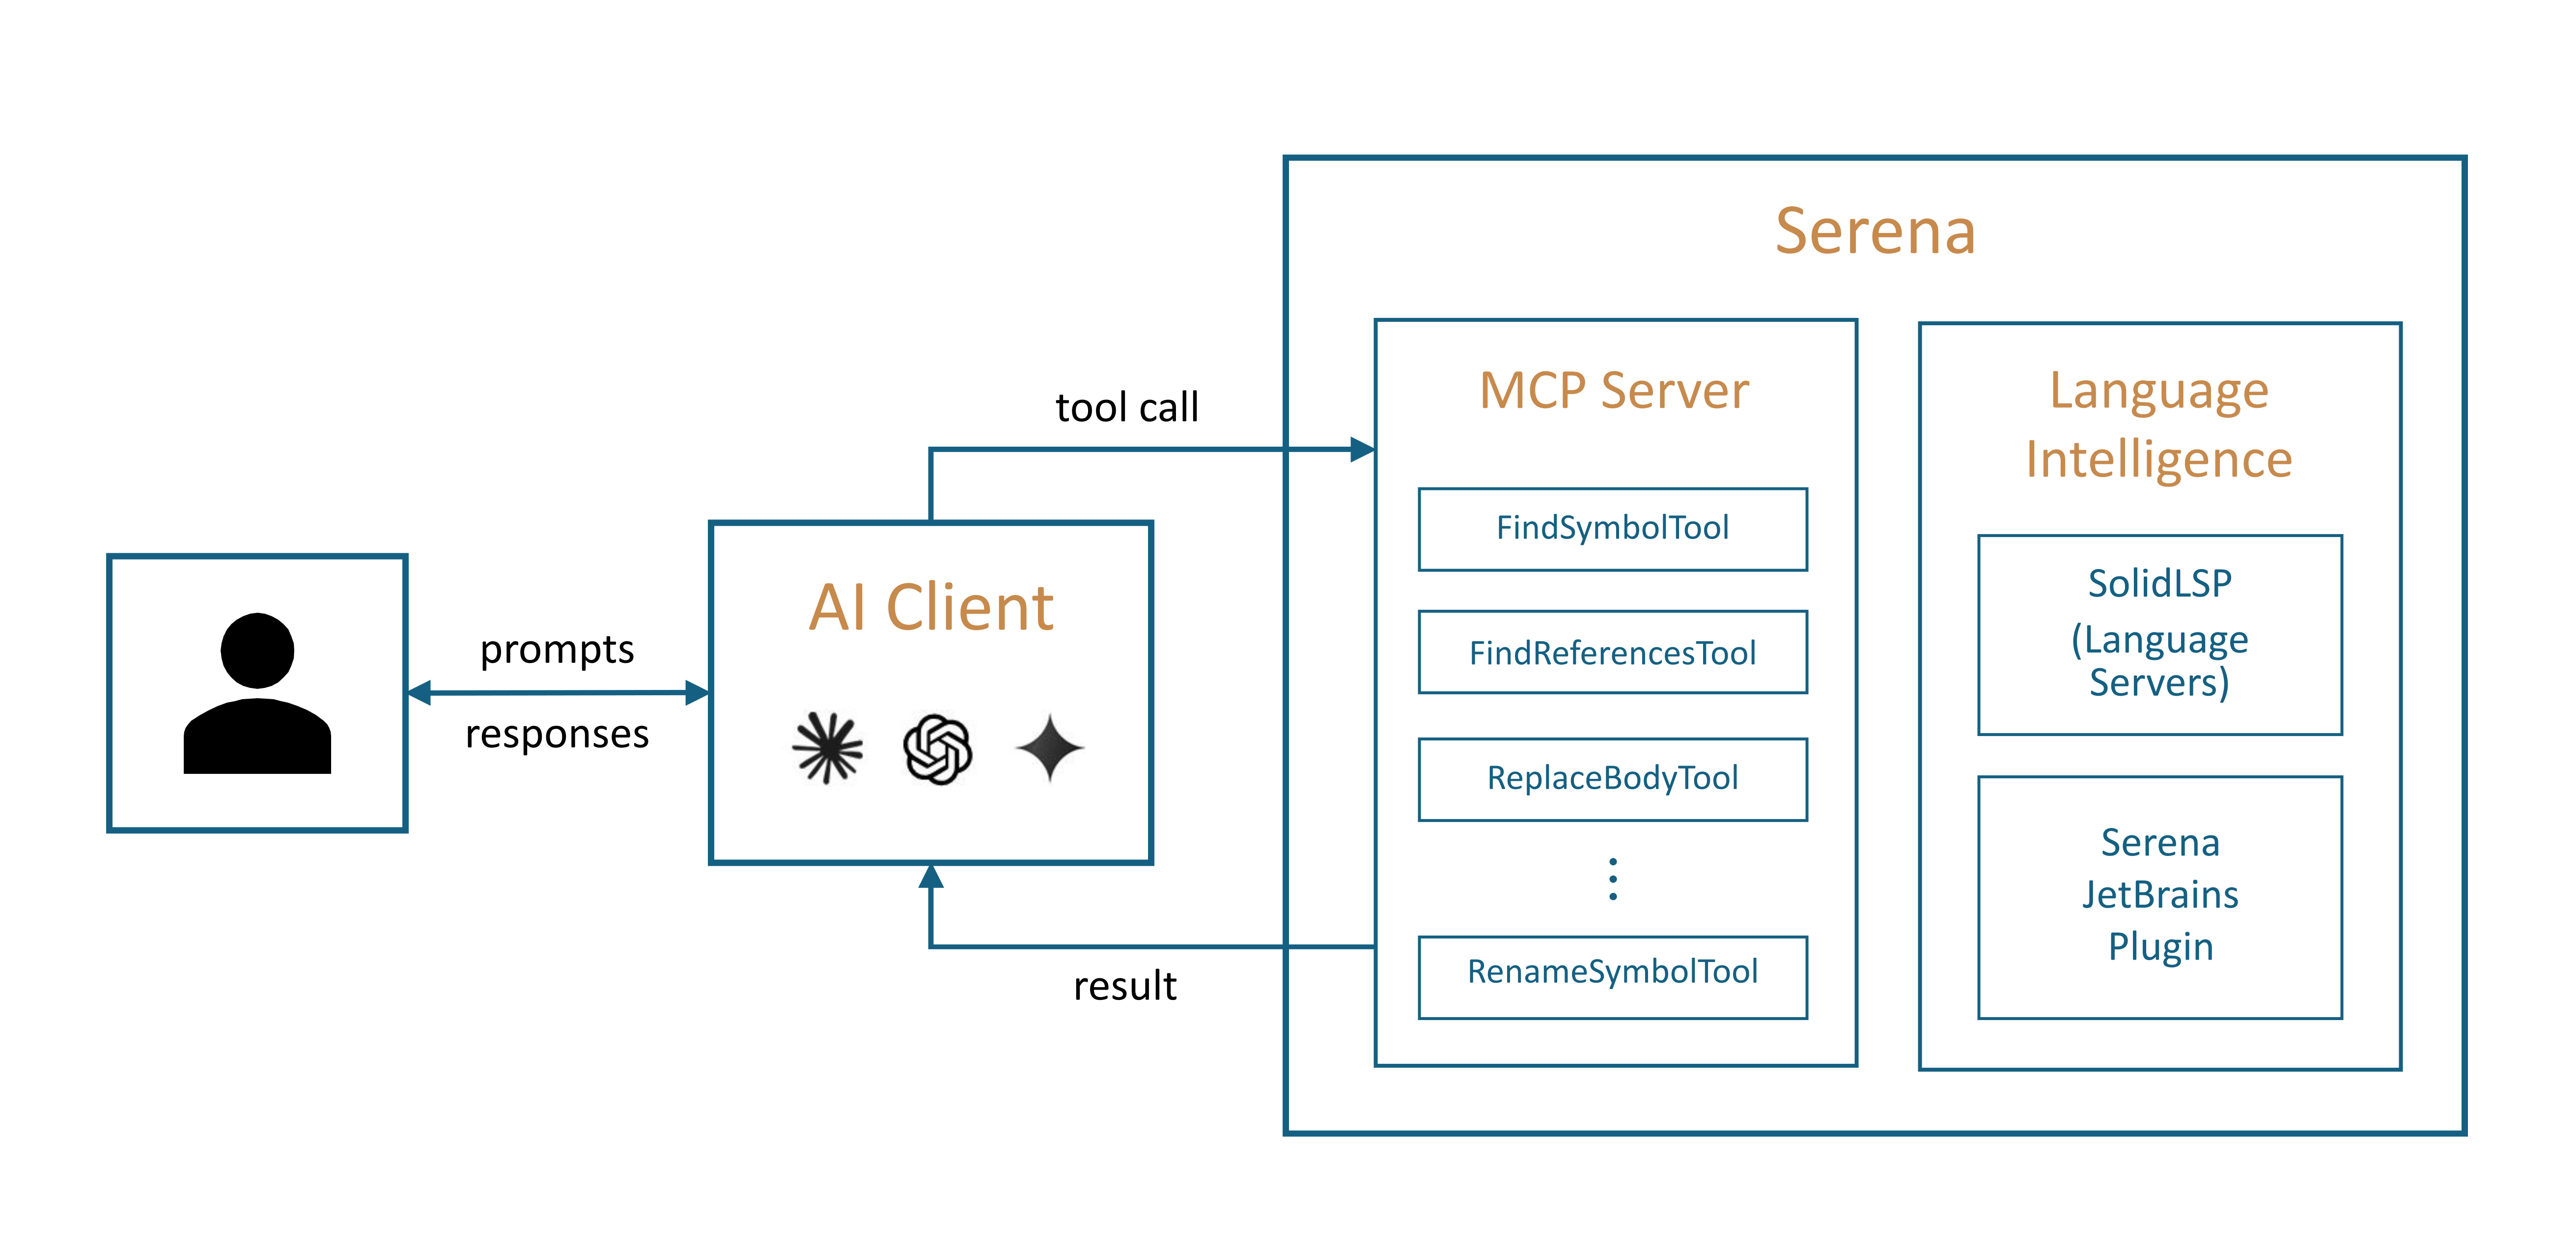
*官方架构图展示模型、MCP工具与代码分析后端的关系。Serena负责提供工具,模型负责选择和组织调用。*
差别在查引用时尤其明显。搜索一个函数名,可能同时命中定义、注释、接口路径和真正调用。语义检索尝试返回代码里的引用关系,可以少做一轮人工筛选。但如果你本来就要找某个报错文案、URL或配置项,普通文本搜索往往更直接。两种工具各有用处。
官方Codex评测里有个具体例子:在Java项目中查Symbol/findReferences,Serena返回6处代码使用;文本搜索还会带出声明、路由字符串和注释。另一个例子先取得千行文件的结构,再只读取约25行的目标方法。这些结果说明了“少读无关内容”怎样发生。官方案例记录
接上MCP,不代表得到全部IDE能力
Serena有两类后端。默认路径使用语言服务器,也就是开发工具常用的LSP机制;另一条路径是付费的Serena JetBrains插件,可试用,并借助IDE的分析与重构能力。官方后端对照
两者都提供符号查找、结构概览和引用检索;具体能力还要看语言及其语言服务器。跨文件移动、内联、类型层次及依赖代码查询等能力,则不能直接按JetBrains演示外推到默认安装。例如官方表格中的移动和内联重构属于JetBrains后端,默认LSP路径没有同等支持。
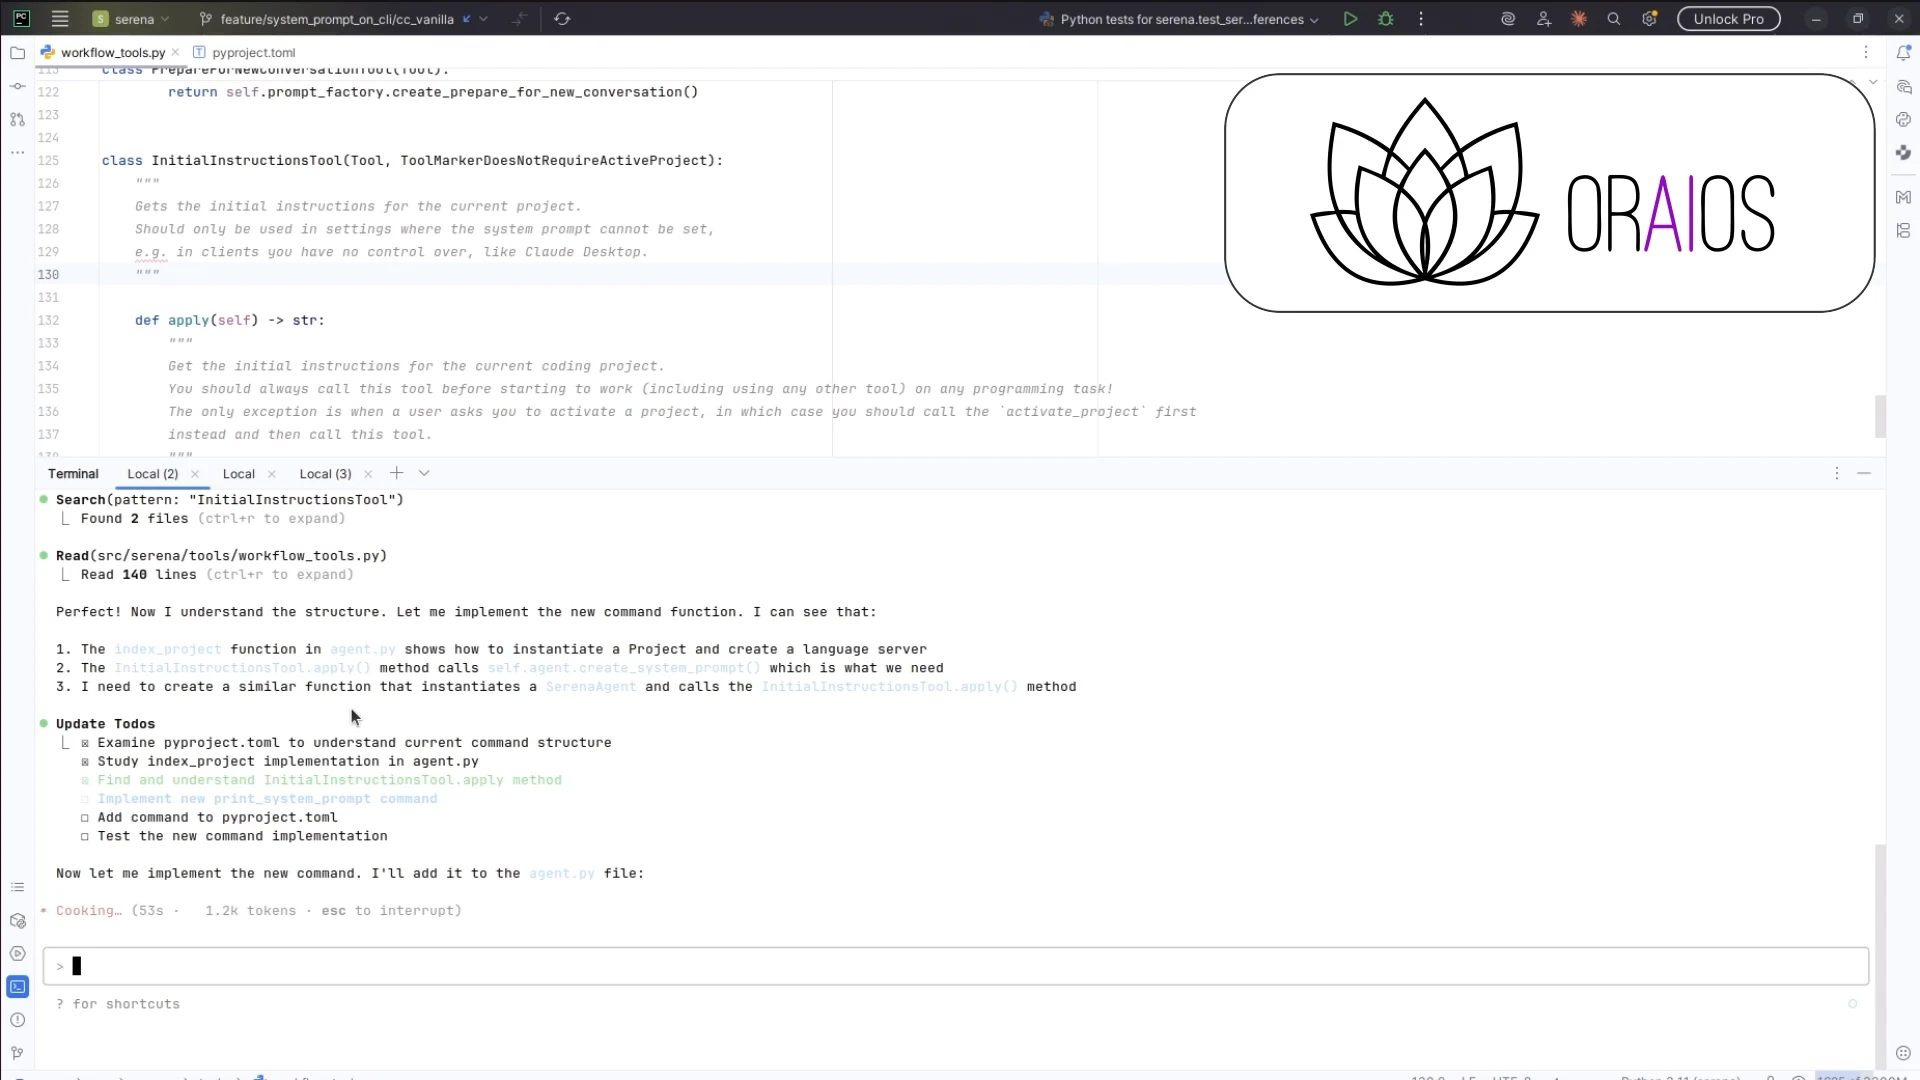
*官方演示第27秒:IDE中的源码与Claude Code调用记录。它用于说明作者展示的工作环境,不是Codex 6.1的效果对测。*
对维护已有项目的人,先让模型准确找到目标、补齐调用关系,通常比追求一键完成所有重构更有价值。真正修改以后,仍要看差异和检查结果:查准了函数,不代表业务判断也一定正确。
仍拿保存提示举例:目标函数找到了,还得确认请求失败、返回数据为空、重复点击时分别会怎样。若问题实际出在调用方,单看保存函数的几行代码也可能误判。好的做法是先从目标出发,按需要补齐上下游;“少读”应减少无关内容,不是把必要背景也省掉。
让Agent验证接入时,也不必一开始就大范围改代码。先让它报告当前项目、列出目标文件的函数,再取一个函数体和几处引用。你能核对返回路径和名字,才能判断它是否真的在使用这套工具。若结果不完整,先检查项目和语言支持;不要把缺失的返回内容误当成“这里没有调用”。
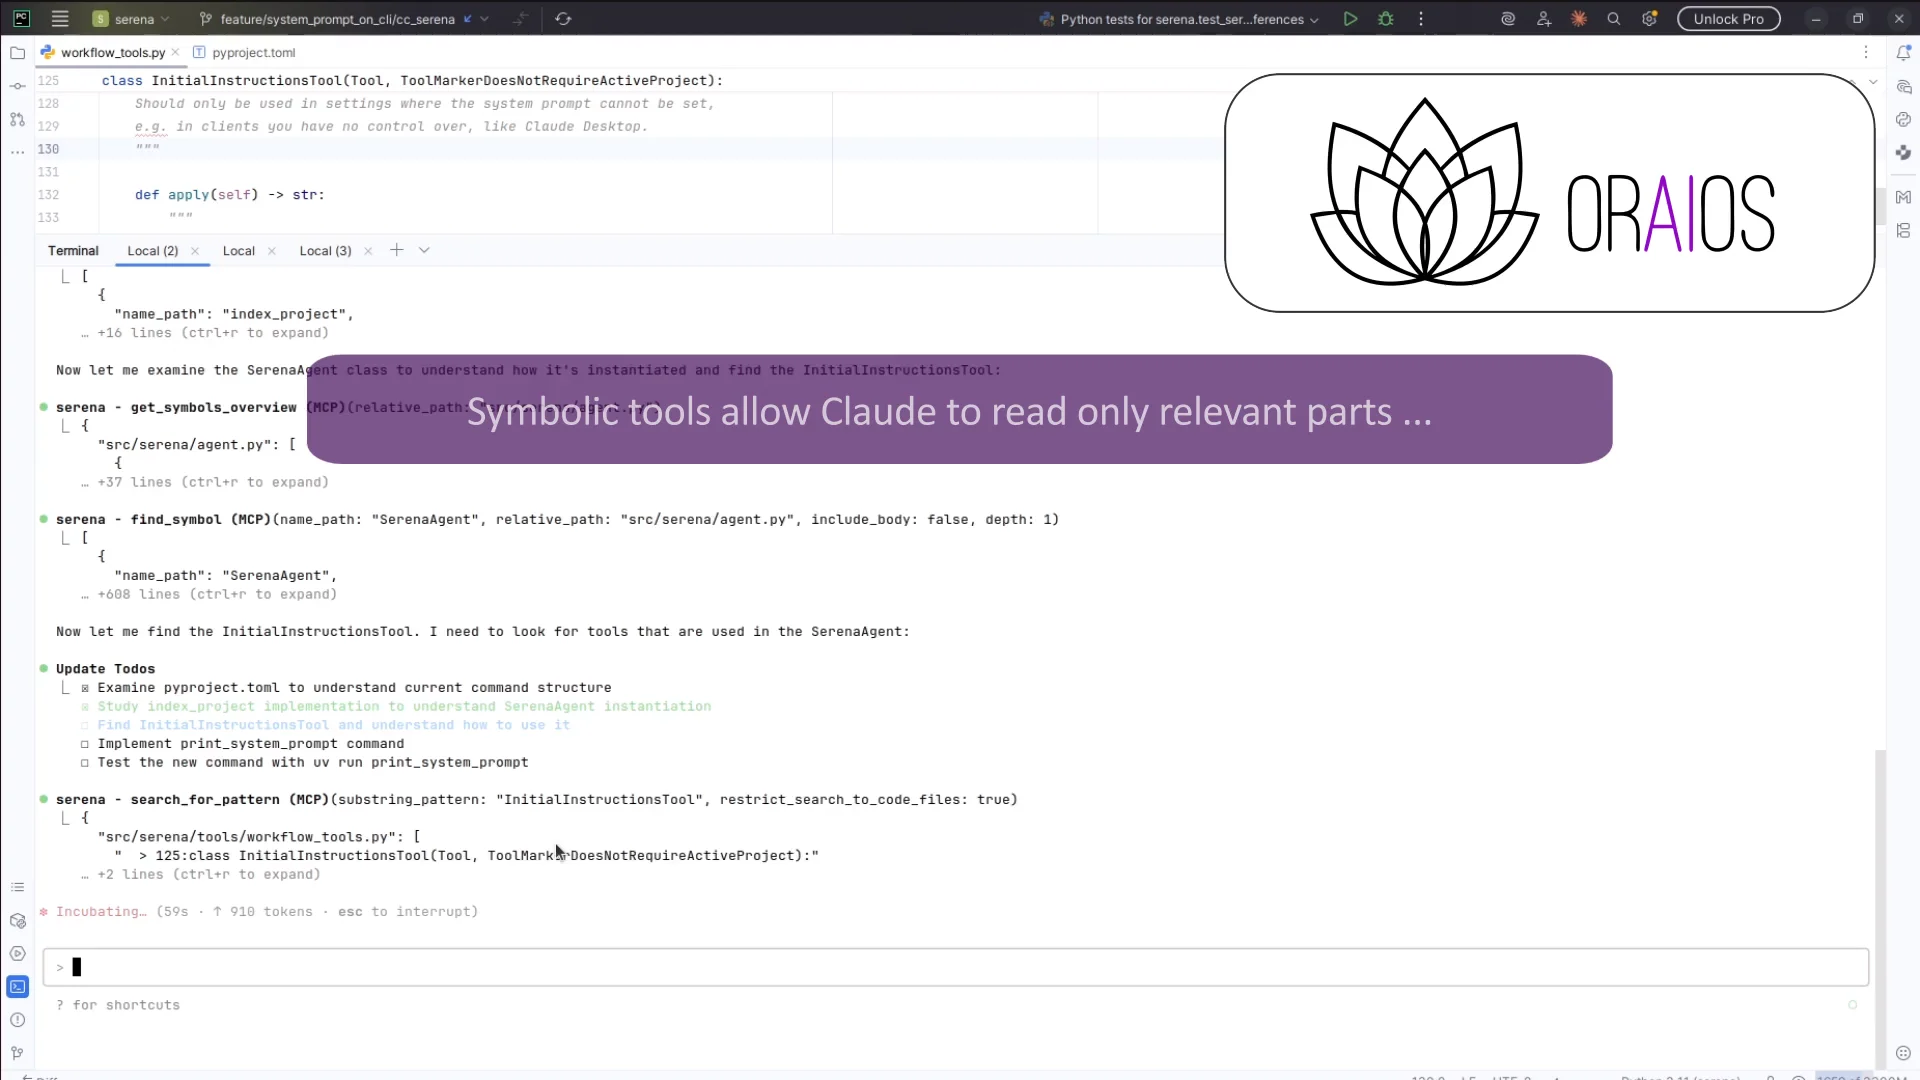
*同一官方演示第88秒出现结构概览和符号查找。它展示了另一种定位过程,两帧不能直接换算成任务节省比例。*
“省90%”缺的是哪一段证据
目前能核对到的公开评测,支持的是有条件的效率收益。上面的Codex报告写于2026年4月13日,模型是GPT-5.4 high,项目是Serena的Java插件,使用JetBrains后端。测试由Agent自己选择任务、分别操作两套工具并记录结果;调用数、返回内容和负面例子有明细,却不是针对Codex 6.1默认LSP配置的统一token账单。评测方法
报告甚至给出了反例:只改一行错误提示,用原生补丁更省;若调用整个方法体替换,可能要发送11行内容。中型方法重写,两边负载相近;跨文件语义重构,Serena更容易减少分散的查找与修改步骤。
| 工作 | 公开案例能支持的判断 |
|---|---|
| 找到已知函数、读取函数体 | 能减少宽泛读取与定位步骤 |
| 区分代码引用与文字提及 | 能减少混杂结果的筛选 |
| 已知位置的一行修改 | 原生补丁可能更轻 |
| 跨文件移动、内联等 | 看后端支持,不能混用演示能力 |
工具返回的字符变少,也不能直接换算为整个任务少花多少。模型还会推理、写代码、调用其他工具;订阅额度与API账单的计算也未必相同。要判断自己是否省,用同一个任务、同一验收要求,比较完成后的总消耗、耗时和返工,比盯着某一次读取有意义。
接入从三条命令开始,项目激活别漏掉
按当前官方文档,先准备uv,再安装和初始化Serena。下面是文档路径,具体语言可能还需额外依赖;不要直接覆盖自己已有的MCP或Hooks配置。官方安装说明
uv tool install -p 3.13 serena-agent
serena init
serena setup codex
随后启动新的Codex会话,检查MCP连接。官方特别提醒:Codex App开启会话的位置可能不在项目目录,需要确认激活的是正确项目;可让Codex执行“Activate the current dir as project using serena”,并核对实际路径。CLI可通过/mcp检查连接状态。Codex接入说明
可以把下面这段交给自己的Agent,先检查再配置:
阅读Serena官方仓库及Codex接入文档。先检查当前系统、uv、
Codex版本、现有MCP配置与当前项目路径,列出必要改动。
保留已有服务器、规则和Hooks,不覆盖整份配置。
按官方支持方式接入,确认激活的项目和连接状态。
最后只选一个函数,验证结构概览、函数体读取与引用查询;
先不修改业务代码,也不把连接成功写成节省token已验证。
先看项目有没有这个痛点
如果你经常在大文件和多个模块之间改动、需要追调用关系,Serena值得进入工具清单。项目很小,或者主要改文案、CSS和配置,原生搜索与补丁可能已经够用。已有其他代码检索工具时,也应先比较缺口,再决定是否增配。
还有一个容易忽略的边界:工具在本地分析代码,不代表模型拿到的代码也留在本地。返回内容仍会进入所用Agent和模型的上下文,私有项目继续遵守自己的数据规则。
比较效果时,把安装、首次准备和日常使用分开记录。一个工具第一次需要配置,不意味着以后每次都同样慢;某次查找很快,也不意味着整项修改更快。最终留下的应该是同一份可验收改动,以及为它付出的完整成本。
Serena最实际的价值,是让模型少翻无关页面,更快把注意力放到需要修改的地方。至于是否省下九成额度,现有资料还给不了这样的保证。先看它是否解决你的查找问题,再算完整任务的账。
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 Kimi K3.1 Pro:跑分逼近 Opus 5.5,白模能变成动画吗?
终端任务与Opus只差0.7个百分点,科学任务却仍有明显距离。结合官方游戏、3D网页和Blender白模案例,拆解Kimi、三维软件与视频模型的分工,并给出可访问的试玩入口。
 71 个 Agent 真会一起干活?ECC 给 Codex 加了什么
ECC的71份Agent定义和311个技能怎样进入Codex?从CSV导出的一次交付拆解规划、验证、Hooks与记忆,核对原生插件和旧同步路径,讲清目录规模、安装成功与任务效果的区别。
 DeepSeek 1017没降价:“更省钱”这笔账怎么算?
单价没变,DeepSeek为什么强调任务成本下降?从新版可比成绩、Agent的完整调用过程,到搜索接口的独立费用,分清已公布的变化与尚未公开的节省幅度。